
内置渲染管线 (Built-in)
固定功能管线: 它的渲染流程是Unity官方预先编写、编译好的一套固定流程。就像一个黑盒,你只能通过一些开关(勾选选项)来调整它,但无法改变它的核心运作方式。
“一个管线应对所有场景”: 它试图用一套逻辑兼顾从手机到PC的所有平台和画质需求。这导致它在任何特定场景下都不是最优的——为了兼容性而显得臃肿,为了功能全面而效率不高。
可编程渲染管线 (SRP: URP & HDRP)
可编程管线: Unity提供了一套底层API(ScriptableRenderContext)和框架,允许你用C#脚本自己编写和控制整个渲染流程。URP和HDRP是Unity官方基于这套API为你写好的两套"模板"或"预设"。
“为特定目标量身定制”: URP和HDRP是利用这套可编程能力,为特定目标(URP为跨平台效率,HDRP为高端画质)从头编写的、极其专注和优化的管线。你甚至可以基于SRP API编写属于你自己团队的定制管线。
URP(Universal Render Pipeline,通用渲染管线)和HDRP(High Definition Render Pipeline,高清渲染管线)的根本区别在于它们的"设计目标"和"目标平台"不同。 它们不是谁比谁更高级的关系,而是为不同需求打造的专用工具。
- URP: 它的诞生是为了取代旧的内置渲染管线 (Built-in Render Pipeline) 和 LWRP (轻量级渲染管线)。它的核心使命是**“一个管线适应所有平台”**。Unity希望开发者能用URP制作从手机到PC再到主机的各种游戏,而无需在项目中期更换管线。它通过高度可定制和优化的方式,在保证不错画质的前提下,极力追求性能。
- HDRP: 它的目标非常明确,就是**“不惜一切代价追求最高画质”**,旨在让Unity能够制作3A级演示和游戏。它假设运行平台拥有强大的GPU和大量的显存,因此可以尽情使用各种耗费资源的尖端技术。
各维度对比
| 特性维度 | URP (通用渲染管线) | HDRP (高清渲染管线) |
|---|---|---|
| 核心目标 | 效率、灵活性、跨平台 | 极致图形保真度、物理正确性 |
| 目标平台 | 移动平台 (Mobile)、PC (中低端)、WebGL | 高性能PC、高端主机 (PS5/Xbox Series X) |
| 渲染路径 | 主要支持前向渲染,也支持延迟渲染,但更轻量 | 主要支持延迟渲染(默认且强大),也支持前向渲染 |
| 光照模型 | 支持PBR,但进行了简化和优化 | 支持完全基于物理的PBR,拥有更复杂精确的光照和材质模型 |
| 光源数量 | 支持每物体少量(通常2-4个)像素光,性能友好 | 支持大量像素光,通过延迟渲染高效处理成百上千的光源 |
| Shader复杂度 | 相对简单,提供有限但高效的Shader功能 | 极其复杂,提供大量用于实现3A级效果的Shader模块和功能 |
| 后处理效果 | 提供常用的后处理效果(Bloom, SSAO, 色彩调整等) | 提供电影级的后处理效果(体积光、屏幕空间反射、精确的景深等) |
| 高级特性 | 不支持或支持简化版的复杂特性 | 全面支持:• 基于物理的相机(镜头畸变、光圈模拟)• 体积雾和光照(上帝之光)• 毛发/布料着色器• 光线追踪 (Ray Tracing) |
| 性能开销 | 低 | 非常高 |
渲染路径 (Rendering Path) - 处理光照的核心差异
这是技术上的一个巨大分水岭。
- URP: 默认且最常用的路径是前向渲染 (Forward Rendering)。这意味着在绘制每个物体时,它的Shader会计算所有影响它的光源。为了性能,URP会严格限制每个物体能接收的实时像素光 (Pixel Light) 的数量(比如默认主光源是像素光,其他光源可能是更便宜的顶点光或球谐光)。它的延迟渲染路径是一个可选项,但功能上比HDRP的延迟渲染要弱。
- HDRP: 默认且最强的路径是延迟渲染 (Deferred Rendering)。这意味着它先不管光照,把所有物体的材质信息(颜色、法线、粗糙度等)都存储到一张叫G-Buffer的"照片"里。然后再用这张"照片"和所有灯光进行运算。这种方法使得渲染成百上千个光源的成本极低,因为成本只取决于屏幕分辨率和光源数量,而与场景复杂度无关。这是实现复杂场景照明的关键技术。
光照与材质 (Lighting & Materials) - 真实感的差距
两者都使用PBR(基于物理的渲染),但层次不同。
- URP: 使用简化版的PBR。它提供了标准的光照模型,但一些更物理精确的参数和计算被简化了,以保证性能。
- HDRP: 使用完全物理正确的光照和材质模型。
- 光照: 光源本身有真实的物理参数,比如灯光的颜色和强度是用物理单位(流明、勒克斯) 来定义的,而不是一个简单的0-1的值。
- 材质: 提供了更丰富的材质类型和更复杂的参数(如次表面散射用于模拟皮肤、玉石,涂层用于模拟车漆等)。
- 天空与全局光照: HDRP拥有更强大的全局光照 (GI) 解决方案,光线在场景中的反弹更真实自然。
为什么SRP(URP/HDRP)性能更好?
1. SRP Batcher (CPU性能提升)
这是SRP管线带来的革命性优化。
传统方式 (Built-in): 每个使用不同材质的物体,即使材质用的是同一个Shader只是参数不同,也会导致GPU中断渲染流程、切换Shader状态,从而产生巨大的CPU开销。这就是Draw Call过多导致CPU瓶颈的原因之一。
SRP Batcher: 它将所有使用了同类Shader(但不一定同材质)的物体的材质数据保存在GPU的显存中的一块特定区域。当渲染这些物体时,它只需要快速更新材质数据(一个常量缓冲区的指针),而无需进行昂贵的状态切换。
结果: 渲染大量使用不同材质但共享同一Shader的物体(比如场景中无数个参数不同的岩石、箱子)时,CPU开销大幅降低,帧率显著提升。
2. 现代化和优化的工作流
更清晰的流程: URP/HDRP的渲染流程是用C#清晰定义的,你可以清楚地看到每个渲染步骤(渲染不透明物体、渲染天空盒、渲染透明物体等),这使得优化和调试变得更加容易。
更少的冗余: URP不会包含HDRP才有的复杂体积光计算代码,反之亦然。每条管线都只包含它目标所需的功能,无比精简高效。
渲染管线
图形渲染管线是实时渲染的核心组件。渲染管线的功能是通过给定虚拟相机、3D场景物体以及光源等场景要素来产生或者渲染一副2D的图像。场景中的3D物体通过管线转变为屏幕上的2D图像。渲染管线是实时渲染的重要工具,实时渲染离不开渲染管线。图形渲染管线主要包括两个功能:一是将物体3D坐标转变为屏幕空间2D坐标,二是为屏幕每个像素点进行着色。
- 准备阶段 (CPU端): 决定要画什么、怎么画。(摄影师布景、调整灯光、安排模特姿势)
- 几何阶段 (GPU端): 把3D模型顶点处理成2D屏幕上的点。(把模特和景物投影到相机的胶片上)
- 光栅化阶段 (GPU端): 把2D点组成的图元(三角形)填充成像素片段。(把胶片的成像冲印成照片)
- 像素处理阶段 (GPU端): 为每个像素计算最终颜色。(给照片进行后期调色、加滤镜)
- 输出与后处理阶段 (GPU端): 最终合并、处理,输出到屏幕。(照片装裱、展览)
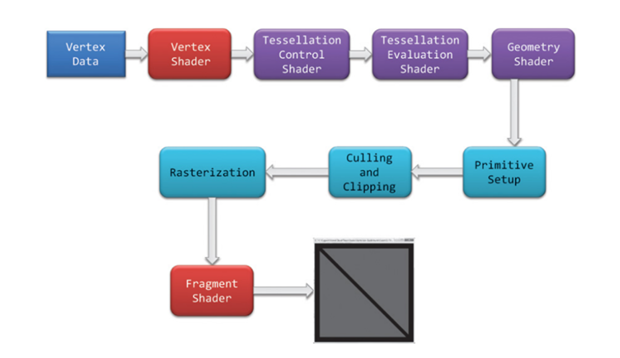
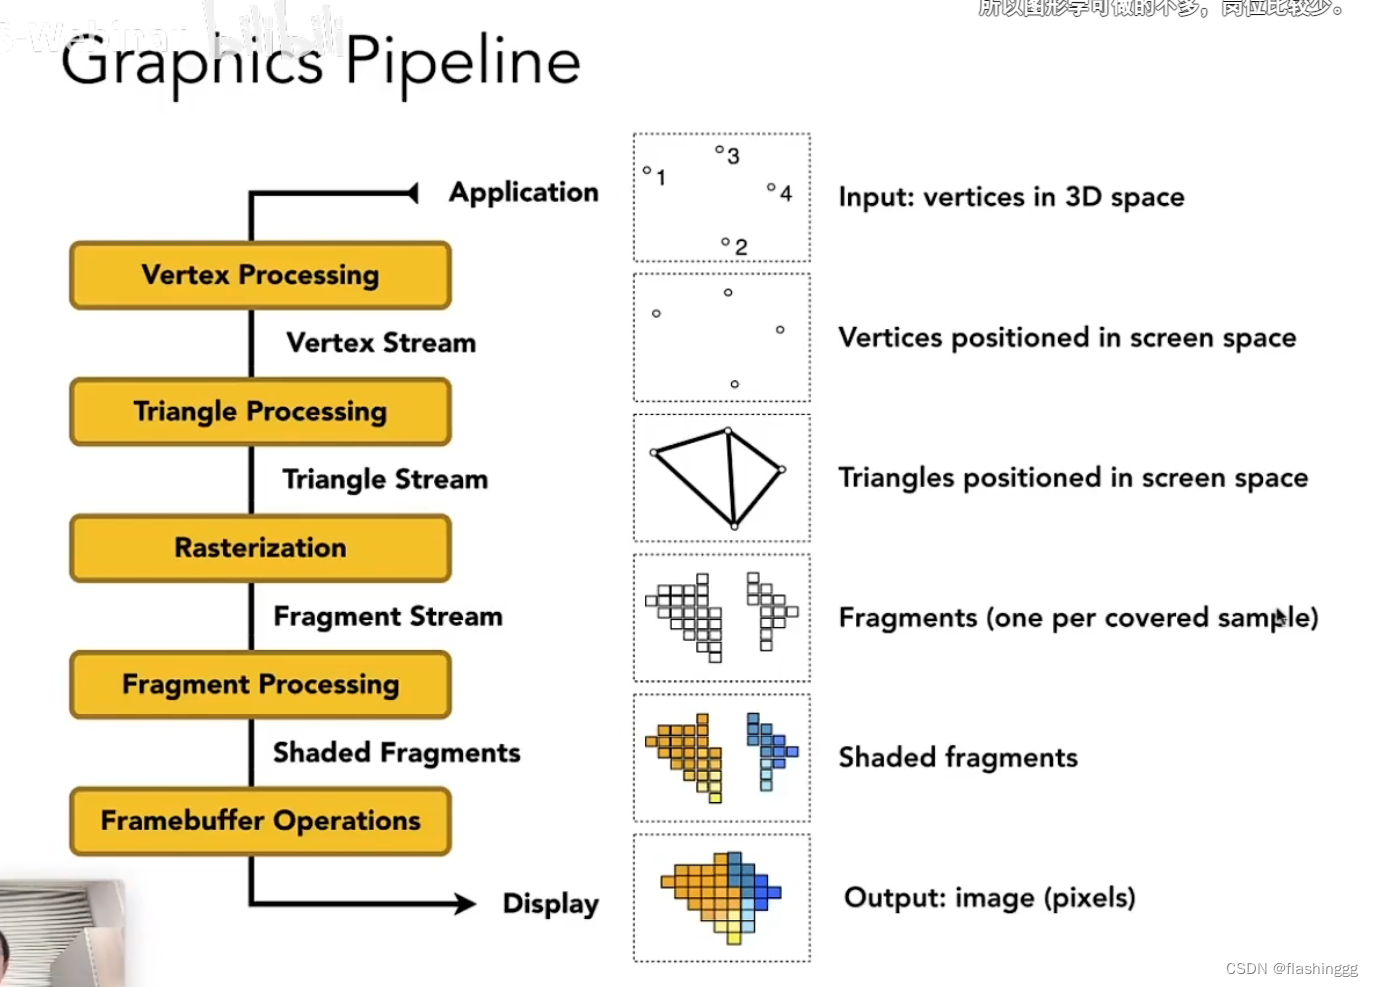
第一阶段:准备阶段 (CPU端 - 渲染流水线的指挥官)
这个阶段主要在CPU上进行,目的是为GPU准备好所有需要渲染的数据和指令。
- 剔除 (Culling):
- 视锥体剔除 (Frustum Culling): 剔除掉完全在摄像机视野之外的物体。这是最基础的优化。
- 遮挡剔除 (Occlusion Culling): 剔除掉被其他物体完全挡住的物体(即使它在视野内)。算法更复杂,但能极大提升性能。
- 排序与合批 (Sorting & Batching):
- 渲染排序: 为了提升效率,通常会对物体按材质、渲染状态(如透明/不透明)进行排序,减少GPU状态切换的开销。
- 动态合批 (Dynamic Batching): CPU将多个小模型的顶点数据合并成一个,用一次Draw Call绘制。节省开支但有限制。
- 静态合批 (Static Batching): 对不会移动的物体进行预处理合批,大幅减少Draw Call。
- 设置渲染状态 (Set Render States): 设置材质(Shader、纹理)、混合模式、深度测试等。
- 构建渲染命令列表 (Build Render Command List): 最终生成一系列"Draw Call"命令,告诉GPU:“画这个模型,用这个材质”。
Draw Call: 是CPU调用图形API(如OpenGL, DirectX)向GPU发起的绘制命令。Draw Call过多是性能瓶颈的主要原因。
第二阶段:几何阶段 (GPU端 - 顶点变形记)
GPU接收到Draw Call命令和顶点数据后,开始处理每个顶点。
- 顶点着色器 (Vertex Shader):
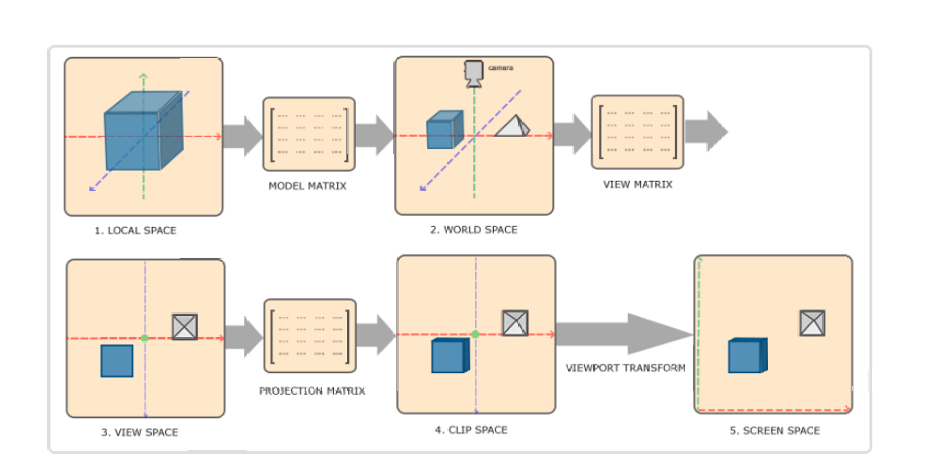
- 核心任务: 处理每个顶点的位置。通常完成模型变换 -> 视图变换 -> 投影变换 (MVP变换),将3D顶点坐标转换到2D屏幕坐标(齐次裁剪空间)以及顶点着色
从输入的顶点局部坐标到最终的屏幕坐标需要经过一系列的坐标变换,才能最终显示到屏幕上。我们从建模工具得到的是物体的局部坐标(Local Coordinate),局部坐标通过模型矩阵Model变换到世界坐标(World Coordinate),世界坐标通过观察矩阵View变换到观察坐标(View Coordinate),观察坐标经过投影矩阵Projection(正交投影和透视投影)变换到裁剪坐标(Clip Coordinate),裁剪坐标经过透射除法(Perspective Division)得到标准设备空间(Normalized Device Coordinates,NDC),NDC坐标通过视口变换(Viewport Transformation)变换到窗口坐标进行显示。
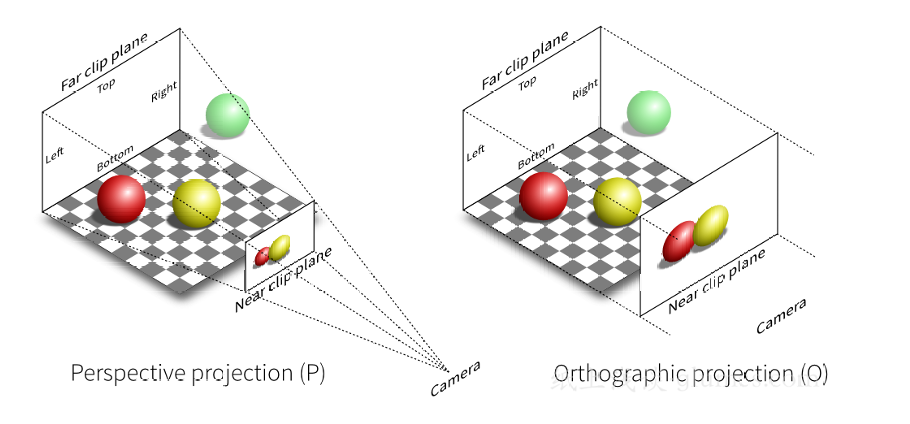
视椎体可以通过上下左右远近六个平面来定义。我们通过投影矩阵将物体从观察空间变换到裁剪空间,裁剪空间是一个以原点为中心的立方体,不在该裁剪空间的图元都会被裁剪。根据投影方式的不一样,我们可以定义不同的投影矩阵,常见的投影方法有:正交投影和透视投影。两种不同投影对应的视椎体如下图所示。我们可以看到正交投影的视椎体是长方体,而透视投影的视椎体是台体。我们可以通过近平面(Near)、远平面(Far)、垂直视场角(Vertical Field of View, FOV)和屏幕纵横比(Aspect Ratio,也叫作屏幕宽高比)四个参数来定义视椎体。
- 曲面细分着色器 (Tessellation Shader)(可选):
- 动态增加模型的三角形数量,让表面更平滑细腻(用于地面、角色皮肤等)。
- 几何着色器 (Geometry Shader)(可选):
- 可以一次处理整个图元(如三角形),甚至生成或销毁图元。用法相对小众。
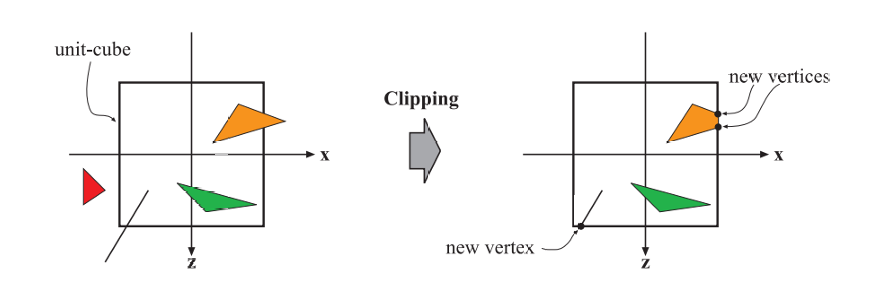
- 裁剪 (Clipping):
- 将超出屏幕(视锥体)范围的三角形进行裁剪,只保留屏幕内的部分。只有当图元部分或全部位于视椎体内时,我们才会将它送到流水线的下个阶段,也就是光栅化阶段。而完全位于视椎体外部的图元会被裁剪掉,不会对它们进行渲染。对于部分位于视椎体的图元,我们需要对他们进行所谓的剪裁操作。
常见的裁剪算法有 Cohen-Sutherland算法、Liang-Barsky算法和Sutherland-Hodgman多边形裁剪算法。
- 背面剔除背面剔除指的是剔除那些背对摄像机的图元,背面剔除的技术默认是不开启的。虽然背面剔除可以大概减少50%的渲染图元,但是在渲染半透明或不透明物体时,不能使用该技术,否则会出现穿帮的情况,因为半透明或不透明物体可以看到物体背后的东西。
- 屏幕映射 (Screen Mapping):
- 将裁剪空间坐标转换到最终的屏幕坐标。
透视除法执行透射除法后(除以w分量),我们可以得到标准设备空间,该空间一般也称作标准视体(Canonical View Volume,CVV)。执行透视除法是为了实现透射投影中近大远小的视觉效果。
视口变换通过透视除法后,我们得到了NDC坐标,获得NDC坐标是为了实现屏幕坐标的转换与硬件无关。经过视口变换后,我们可以得到窗口坐标(Window Coordinates)。除了窗口坐标,还有屏幕坐标(Screen Coordinates)。
第三阶段:图元装配 (Primitive Assembly)
这是连接顶点处理和光栅化的桥梁
输入: 顶点着色器处理后的、一堆离散的顶点。
指令来源: CPU在发出Draw Call时,不仅传递了顶点缓冲区(Vertex Buffer),还传递了图元类型(如GL_TRIANGLES)和索引缓冲区(Index Buffer)。
索引缓冲区 就是一个简单的列表,它告诉GPU:“请用第0、1、2号顶点组成第一个三角形,用第1、2、3号顶点组成第二个三角形……”
处理过程: 图元装配阶段根据Draw Call的指令(图元类型和索引缓冲区),将离散的顶点连接成具体的几何图元(在大多数情况下就是三角形)。
输出: 完整的、连接好的三角形(或其他图元),每个三角形由三个顶点及其所有插值后的属性组成。
第四阶段:光栅化阶段 (GPU端 - 从向量到像素)
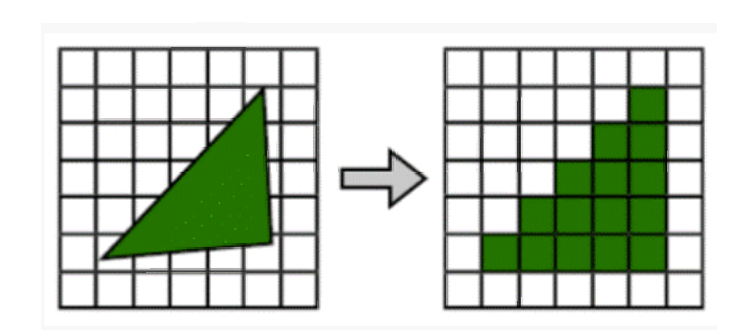
这个阶段将连续的几何图形(三角形)离散化为一个个的像素(更准确地说,是片段-Fragment)。
离散化过程是利用三角图元所覆盖的片段来表示该图元。这里有个概念需要我们注意,就是如何定义图元覆盖(Overlap)一个片段。如果我们采用最简单的点采样(Point Sampling)而且采样点位于片段的中央位置。当采样点位于图元的内部时,我们认为图元覆盖了该片段。这是最简单的采样方式,除此还有超级采样和多重采样技术。
- 三角形组装 (Triangle Setup): 三角形组装会对顶点的输入数据(比如,颜色、法线、纹理坐标)进行插值,得到各个片段对应的数据值,为后面的片段着色提供片段数据。一般情况下,我们很少去插值颜色值,通常都是利用片段着色器对片段进行着色。
- 三角形遍历 (Triangle Traversal) / 扫描转换 (Scan Conversion):通过屏幕空间的坐标组装三角形后,我们遍历这些三角图元覆盖了哪些片段的采样点,随后得到该图元所对应的片元。接下来我们通过顶点的输入数据插值获取片段的数据属性,包括颜色、法线、纹理坐标、深度等信息。对于透射投影,我们需要用到透射校正插值(Perspetive-Correct-Interpolation)来正确插值片段的颜色、纹理等信息。
- 检查每个像素的中心是否在三角形内。如果是,就为该像素生成一个片段 (Fragment)。片段包含了插值后的数据(颜色、法线、深度、UV等),它是潜在像素。
衍生面试题:如何判断点在三角形内部?
最常用且最高效的方法是 重心坐标法。另一种直观的方法是 同向法/叉积法。
方法一:重心坐标法 (Barycentric Coordinates) - GPU 实际使用的方法
这是现代 GPU 光栅器最可能采用的方法,因为它不仅能判断是否在内部,还能自然地计算出用于插值的权重。
核心思想
任何三角形内的点 P,都可以表示为三角形三个顶点 (A, B, C) 的加权和。这些权重 (u, v, w) 就称为点 P 相对于三角形 ABC 的重心坐标。
P = u * A + v * B + w * C其中 u + v + w = 1 且 u >= 0, v >= 0, w >= 0
如果任何一个权重为负数,则点 P 就在三角形外部。
如何计算权重?
重心坐标可以通过计算子三角形的面积比来得到。点 P 的重心坐标 u 与顶点 A 对面的子三角形面积(即三角形 PBC 的面积)成正比。
更具体的计算公式如下(基于叉积):
- 计算整个三角形的面积(的两倍):
area_ABC = (B - A) × (C - A)(这是一个向量叉积,取其模长即为两倍面积) - 计算子三角形的面积(的两倍):
area_PBC = (B - P) × (C - P)-> 权重u正比于此面积area_PCA = (C - P) × (A - P)-> 权重v正比于此面积area_PAB = (A - P) × (B - P)-> 本来应是权重w,但通常用计算w = 1 - u - v - 归一化得到准确的权重:
u = area_PBC / area_ABC``v = area_PCA / area_ABC``w = 1 - u - v(因为u + v + w = 1) - 判断条件:如果
u >= 0且v >= 0且w >= 0(即u + v <= 1),则点 P 在三角形内部或边上。只要u,v,w中有任何一个小于 0,点 P 就在三角形外部。
**为什么 GPU 喜欢这个方法?**因为光栅化的目的不仅仅是判断像素中心是否在三角形内,更重要的是要对顶点属性(颜色、法线、UV等)进行插值。而重心坐标 (u, v, w) 本身就是现成的、完美的插值权重!片段着色器中得到的插值后的变量,正是通过这个权重计算出来的:fragment_color = u * color_A + v * color_B + w * color_C
方法二:同向法 / 叉积法 (Cross Product Method)
这个方法更直观,易于理解,非常适合在面试中解释。
核心思想
如果点 P 在三角形 ABC 的内部,那么它一定位于三角形三条边的同一侧(对于顺时针三角形来说是“右侧”,对于逆时针三角形来说是“左侧”)。
步骤:
- 首先,约定三角形的顶点顺序(例如 A -> B -> C),这决定了三角形的“正面”是哪个方向。通常我们使用逆时针顺序表示正面。
- 计算三次叉积,检查点 P 是否对于三条边都在“正面”的一侧:
- 计算边 AB 和向量 AP 的叉积:
edge1 = (B - A), vector1 = (P - A)->cross1 = edge1 × vector1 - 计算边 BC 和向量 BP 的叉积:
edge2 = (C - B), vector2 = (P - B)->cross2 = edge2 × vector2 - 计算边 CA 和向量 CP 的叉积:
edge3 = (A - C), vector3 = (P - C)->cross3 = edge3 × vector3
- 计算边 AB 和向量 AP 的叉积:
- 判断条件:如果三次叉积结果的 符号相同(即 Z 分量同时 >= 0 或同时 <= 0),则点 P 在三角形内部。如果符号不同,则点 P 在三角形外部。
注意:由于三角形的缠绕顺序(顺时针/逆时针)会影响叉积的符号,所以判断的是“符号是否一致”,而不是符号的正负。
锯齿和抗锯齿
3D场景中的物体是连续的,而2D屏幕空间的像素点是离散的,当我们使用离散的像素点来表示连续的物体时,丢失了物体连续的信息,导致锯齿的产生。我们从前面光栅化阶段已经知道了一个片段是如何产生的,它是抗锯齿技术的基础,接下来主要介绍超级采样和多重采样抗锯齿两种技术。
**超级采样抗锯齿 (Super-Sampling Anti-aliasing)**最直接最好的抗锯齿方法就是SSAA,拿4xSSAA来说,假设屏幕分辨率为800x600,那么4xSSAA会将屏幕渲染到1600x1200的缓冲区上,然后在下采样到800x600,SSAA可以得到非常好的抗锯齿效果,不过SSAA需要的计算量是非常大的,光栅化和片段着色器都是原来的4倍,渲染缓存的大小也是原来的4倍。
**多重采样抗锯齿 (Multi-Sampling Anti-aliasing)**在前面的光栅化阶段,我们知道每个片段都有一个采样点,决定一个片段是否被三角面覆盖的方法就是看是否覆盖了该采样点。在MSAA中我们会使用多个采样点来决定覆盖率的问题(Coverage)。MSAA的原理其实和SSAA差不多,不过在光栅化阶段计算三角面是否覆盖了片段的每个采样点,得到采样点覆盖率的数值,接下来在片段着色器计算这个片段的颜色值(只计算一次),然后最终的颜色会乘上这个覆盖率。
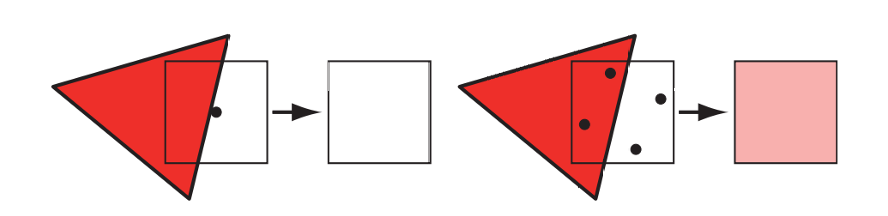
以上图第二个图的4xMSAA为例,我们发现三角形覆盖了4个采样点中的两个,所以最终片段得到的颜色值需要乘以采样点覆盖率0.5,得到的是浅红色的颜色。MSAA的主要问题在于它跟延迟渲染(Deferred Rendering)并不兼容,因为延迟渲染需要Geometry和Lighting两个pass,在光照阶段无法通过GBuferf获取片段的覆盖率信息。
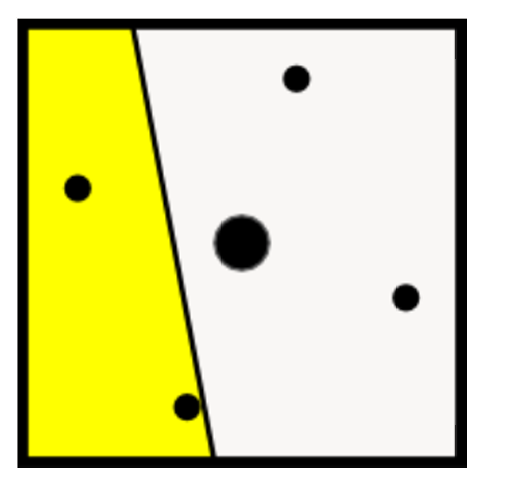
上面讲到的MSAA计算方式在下面这种情况下会出现问题。我们这里使用的是4xMSAA,但是我们在片段着色器中利用的是片段的中心位置(图中的中央的圆点)作为采样点来决定最终的颜色,但是我们发现此时三角面是没有覆盖到该采样点,所以最终输出的颜色时错误的。此时我们会使用重心采样(centroid sampling)来解决这个问题。重心采样是由GPU自动执行的,GPU通过覆盖的采样点的来确定采样的重心点,以此避免上面提到的采样点位于三角面外部的问题。
除了我们上面提到的SSAA和MSAA之外,还有很多其他的抗锯齿技术,比如:覆盖采样抗锯齿(CSAA)、可编程过滤抗锯齿(CFAA)、快速近似抗锯齿(FXAA)、时间样本抗锯齿(TXAA)、多帧采样抗锯齿(MFAA)、形态抗锯齿(MLAA)、增强型抗锯齿(EQAA)、亚像素形态抗锯齿(SMAA)。
第五阶段:像素处理阶段 (GPU端 - 决定像素最终颜色)
这是最复杂、最灵活的阶段,现代图形学的很多特效都在这里发生。
在计算机图形中颜色被表示为有4个元素的数组:红色、绿色、蓝色和alpha(透明度)分量,通常缩写为RGBA。
- 片段着色器 (Fragment Shader) / 像素着色器 (Pixel Shader):
- 核心任务: 计算每个片段的最终颜色。
- 工作原理: 使用从顶点着色器插值过来的数据(如UV),进行纹理采样 (Texture Sampling),并应用光照模型进行计算。
- 现代核心:PBR(基于物理的渲染): 这是当前主流的高质量光照模型。它使用金属度 (Metallic)、粗糙度 (Roughness) 等物理参数,配合图像-Based Lighting (IBL) 来模拟非常逼真的光照效果。
纹理贴图
纹理贴图也成为纹理映射,是将图像信息映射到三角形网格上的技术,以此来增加物体表面的细节,令物体更具有真实感。纹理技术有很多,最常见的是凹凸贴图(bump mapping)、法线贴图(normal mapping)、高度纹理(height mapping)、视差贴图(parallax mapping)、位移贴图(displacement mapping)、立方体贴图(cubemap)、阴影贴图(shadowmap)。凹凸贴图、法线贴图等技术都是利用光照信息的明暗对比来产生视觉错误。纹理贴图是片段着色器的主要操作,通过贴图技术可以实现很多高级的效果。我们将贴图上的每个像素成为纹素(texel,纹理像素texture pixel的意思,用于和像素进行区分),纹理映射其实就是进行纹素和像素对应的过程。
纹理常见的一种应用是凹凸映射(bumping mapping),该技术由Blinn引入的。凹凸映射一般有两种方式:一种是使用高度纹理(height map),利用高度图来修改表面的法线,这种方式也被称为高度映射(height mapping);还有另一种方式是使用法线贴图(normal map),这种方式一般称为法线映射(normal mapping),该技术由Peercy引入的,法线贴图直接存储的就是物体表面的法线,而高度贴图需要计算物体表面的法线扰动信息,所以说使用法线贴图会比使用高度贴图有更高的性能。
光照模型
phong模型计算光照最常用的模型就是大名鼎鼎的phong模型了,该模型其实是经验模型,参数信息都是经验得到的,并没有实际的物理意义,所以利用Phong模型会出现违背物理规则的时候。Phong模型将物体光照分为三个部分进行计算,分别是:漫反射分量、镜面高光和环境光。其中,环境光分量是用来模拟全局光照效果的,其实就是在物体光照信息基础上叠加上一个较小的光照常量,用来表示场景中其他物体反射的间接光照。
Blinn-Phong模型Blinn-Phong模型是对我们上面讲到的Phong模型的改进,Phong模型在处理高光时会出现光照不连续的情况。我们知道高光跟观察位置密切相关,当观察方向和反射光线夹角大于90度时(如上图所示),Phong模型会出现镜面反射分量被消除的情况,所以出现高光不连续的现象,如下图的第一种图所示。我们可以通过Blinn-Phong模型来对它进行改进,下面两张图对比了这两种模型在处理高光时的差异。
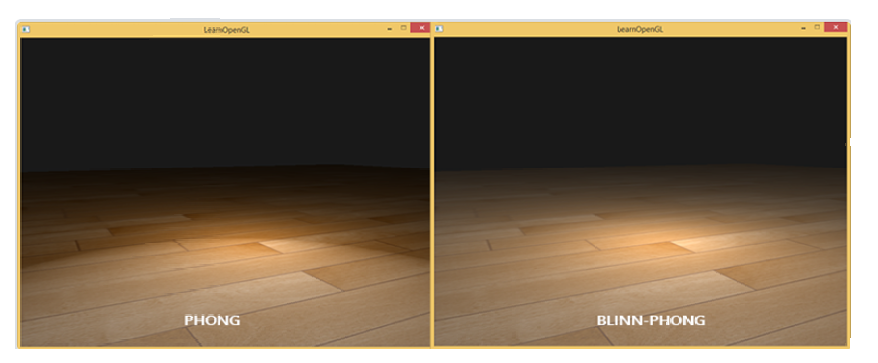
Blinn-Phong模型在处理镜面反射时不使用观察方向和反射光线的夹角来计算,而是引入了一个新的向量:半角向量(Halfway vector)。半角向量其实很简单,就是光线向量L和观察方向V的中间位置。Blinn-Phong模型计算的就是半角向量H和平面法线的夹角(当视线和反射向量对齐时,有最大的镜面反射),这样无论观察者在那个方向进行观看,半角向量和法线夹角都不会超过90度,不会出现上面说的高光不连续的问题,光照效果更佳真实。
这些模型是基于观察和经验的简化模型,它们的目的是"看起来对",而不是"物理正确"。
**PBR(基于物理的渲染)**它的目标是"物理正确",这意味着材质参数本身具有真实的物理意义,一旦设置好,它在任何光照环境下都能表现出正确、一致的行为。
- 逐片段操作 (Per-Fragment Operations):
- 深度测试 (Depth Test): 比较片段的深度值(Z值)和深度缓冲区(Z-Buffer)中的值。丢弃被遮挡的片段。这是解决 visibility 问题的关键技术。
- 模板测试 (Stencil Test): 利用模板缓冲区(Stencil Buffer)来标记特定区域,实现如轮廓、镜子等特效。
- 混合 (Blending): 如何处理片段颜色和帧缓冲区(Frame Buffer)中已有颜色的混合。主要用于渲染透明物体(如玻璃、火焰)。
第六阶段:输出与后处理
- 输出到帧缓冲区 (Frame Buffer):
- 通过所有测试的片段,将其颜色值写入到帧缓冲区。帧缓冲区就是最终要显示的图像。
- 后处理 (Post-Processing):
- 对整张渲染好的图像(帧缓冲区)进行屏幕空间的特效处理。
- 常见效果:
- Bloom: 泛光效果,让明亮区域扩散出光芒。
- 色调映射 (Tone Mapping): 将HDR(高动态范围)的颜色转换到屏幕能显示的LDR(低动态范围)。
- 颜色校正 (Color Grading): 调整整体颜色和氛围。
- 景深 (Depth of Field): 模拟相机焦点清晰、背景模糊的效果。
- 屏幕空间环境光遮蔽 (SSAO): 在屏幕空间计算细微的阴影,增加场景的立体感。
- 后处理通常通过在全屏四边形上执行一个特殊的Shader来实现。
- 最终呈现:
- 将帧缓冲区的内容交换到前台,显示在你的屏幕上。
渲染路径 (Rendering Path)
引擎如何处理光照。主要有两种:
前向渲染 (Forward Rendering)
- 原理: 在每个物体的片段着色器中,对所有影响该片段的光源进行循环计算,也就是说每一个物体都要计算所有光照对他产生的影响。
- 优点: MSAA等抗锯齿支持好,Shader编写直观。
- 缺点: 光源数量多时性能下降极快(计算量指数级增长)。
- 适用: 移动平台、光源数量较少的场景。
延迟渲染 (Deferred Rendering)
延迟渲染的核心思想是:将几何和光照计算完全分离开。它先处理完所有物体的几何信息,再统一处理所有光源的光照。它"延迟"了昂贵的光照计算。
流程(分为两个独立的Pass):
Pass 1: 几何通道 (G-Buffer Pass)
- 目标: 不计算任何光照,只存储所有物体的几何信息(材质属性)。
- 过程: 渲染所有物体。片段着色器变得非常简单,只负责将各种材质属性输出到多个渲染目标(MRT)中。这些渲染目标集合被称为 G-Buffer(Geometry Buffer)。
- G-Buffer 通常包含:
- 漫反射颜色 (Albedo)
- 世界空间法线 (World Normal)
- 世界空间位置 (World Position)
- 金属度/粗糙度 (Metallic/Roughness) 等PBR参数
- 结果: G-Buffer就像一张张"照片",记录了屏幕上每个像素对应物体的"身份信息"和"材质信息"。
Pass 2: 光照通道 (Lighting Pass)
- 目标: 利用G-Buffer中的信息计算光照。
- 过程:
- 不再绘制任何场景物体。
- 针对每个光源,在屏幕上绘制一个代表其影响范围的形状(球体用于点光,锥体用于聚光,全屏Quad用于方向光)。
- 在绘制这些形状时,对覆盖的每一个像素,从G-Buffer中读取该位置的法线、位置、颜色等信息。
- 然后像在前向渲染中一样,执行一次光照计算,但这次只计算当前这一个光源的贡献。
- 将所有光源的贡献叠加混合起来,得到最终的画面。
核心优势:光照计算复杂度复杂度变成了 O(N),只与屏幕上的像素数量和光源数量有关,而与场景的几何复杂度(物体数量M)完全无关。渲染1000个三角形和渲染100000个三角形的场景,如果最终屏幕像素数和光源数相同,其光照计算开销是一样的。这使得它极其擅长处理拥有大量光源的复杂场景。
现代引擎(如URP/HDRP)通常会提供混合方案,如前向+ (Forward+)。
阴影 (Shadows)
阴影和光是这个世界的一体两面,有光的地方就会产生影子。阴影对于渲染真实感来说非常重要,它给出了物体在3D世界中的位置信息。对于静态的物体,我们可以使用Lightmap烘焙的方法来获取物体的影子,而对于动态的物体,一般采用的是Shadowmap的技术。该技术其实是一种渲染到纹理的技术,我们得到的这张贴图一般称作阴影贴图。
Shadowmap的原理非常简单,首先是从光源的位置渲染一遍场景,将得到的深度信息写入到贴图中,然后再一次正常的渲染场景,利用我们得到的shadowmap来判断哪些片段落在了阴影中。
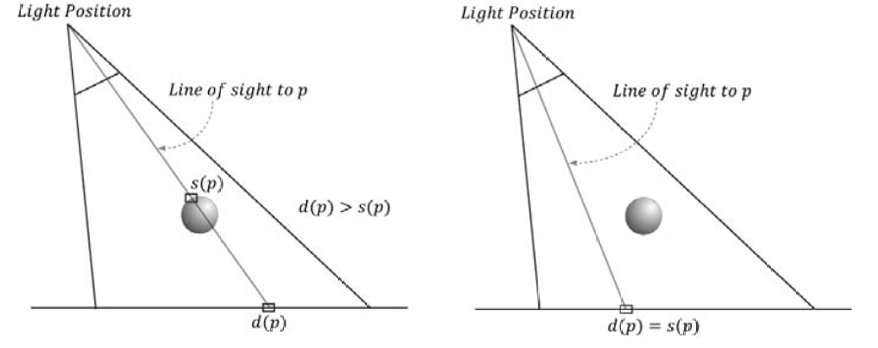
在上面的左图中,我们从光源的角度看,像素p的深度值为d(p),但是从阴影贴图中我们发现离光源最近的像素深度值其实是s(p),而且d(p) > s(p)。所以我们可以得到像素p之前有物体挡住了它,因此p点落在了阴影当中。右图中,我们发现像素p的深度值d(p)=s(p),因此像素p没有落在阴影中。
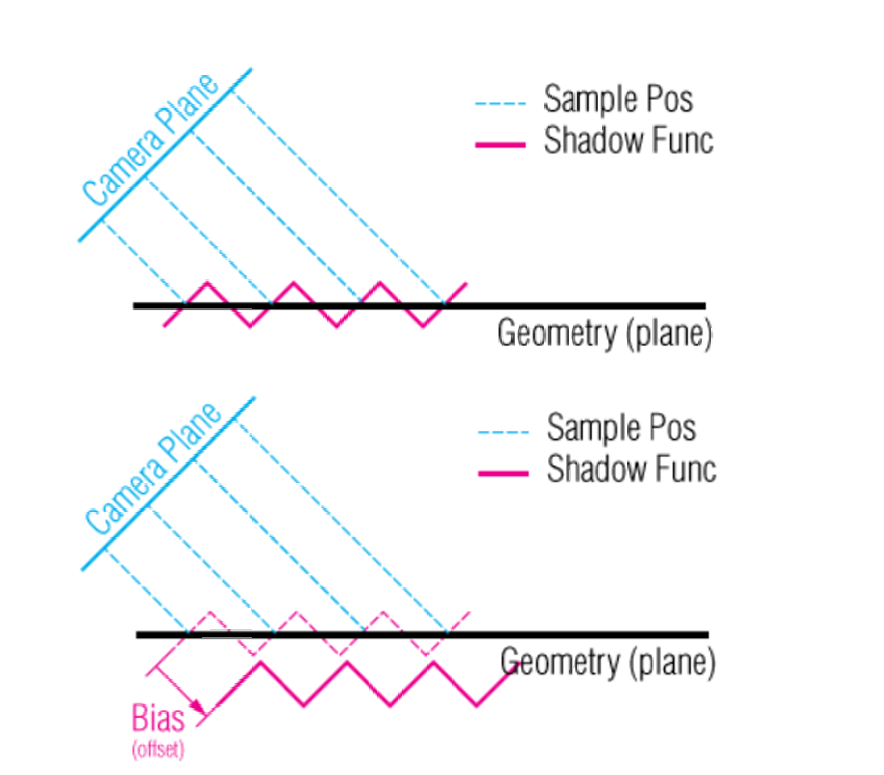
由于shadowmap精度的问题,阴影会出现阴影粉刺(shadow acen)。对于阴影粉刺我们可以通过偏移量对阴影贴图中的深度值进行调整,我们发现调整前平面会有某些像素深度比深度贴图大,某些像素深度比深度贴图小,所以导致了某些地方有阴影某些没有的粉刺现象,经过了偏移后,所有像素点的深度值都比深度贴图大,没有了粉刺现象。不过我们如果偏移太大的话,会出现阴影偏离物体的失真现象。偏移量的大小和平面的倾斜度有关,平面越倾斜的话,需要的偏移量就越大。
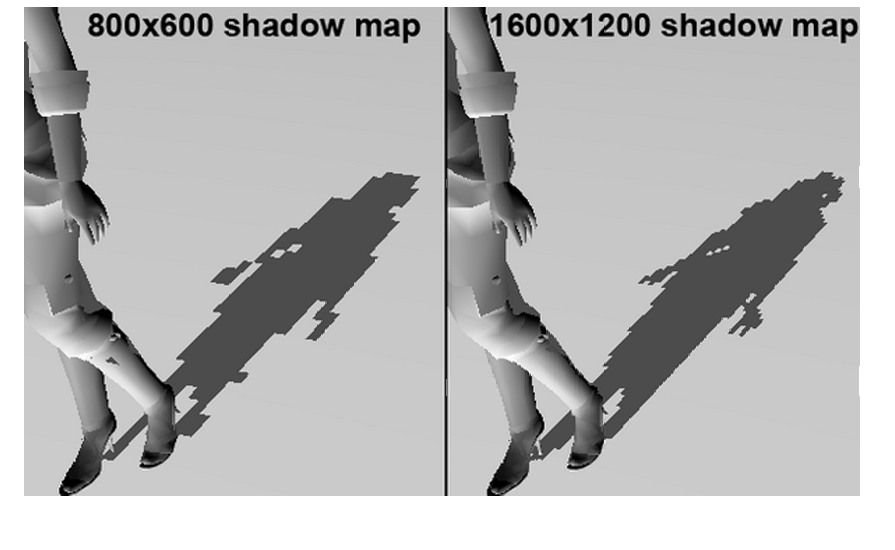
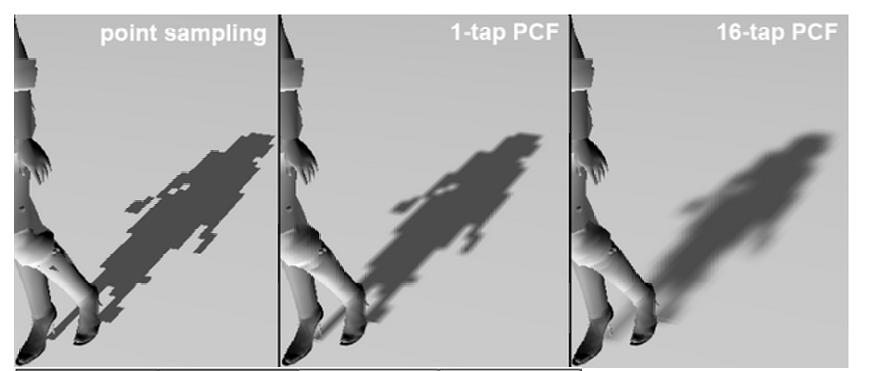
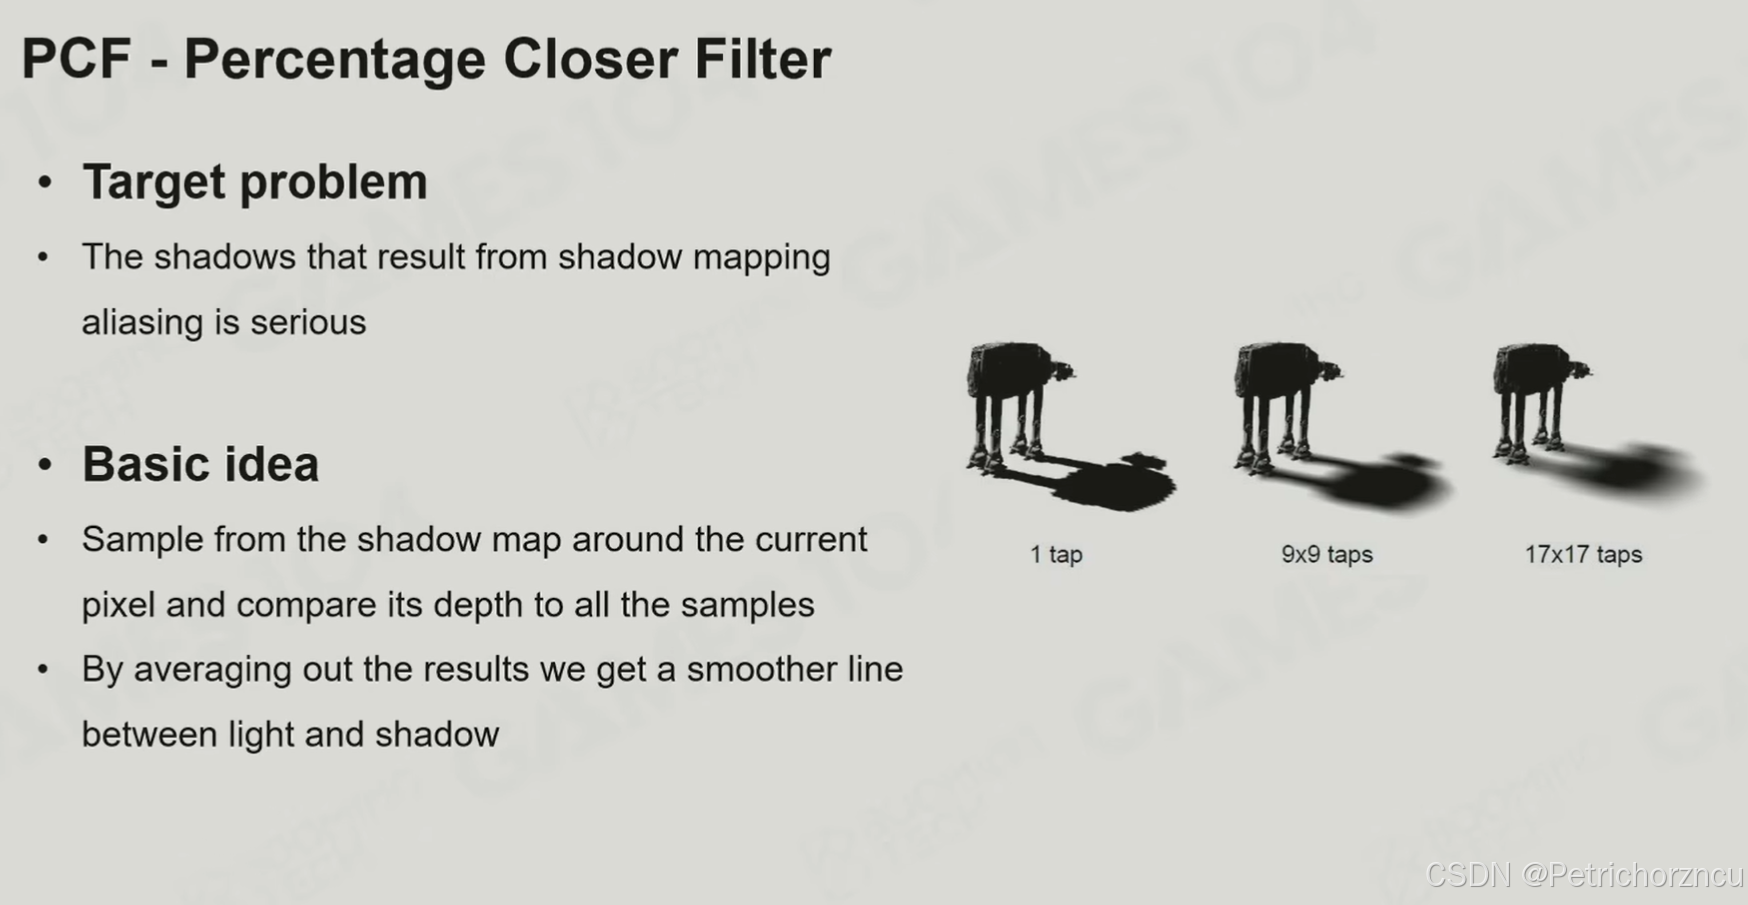
除了阴影粉刺之外,还有阴影走样(aliasing)的问题,如上图所示。虽然我们可以通过提升shadowmap的分辨率来降低走样的影响,但是同时也增大了显存的消耗。所以通常使用百分比渐进过滤(Percentage Closer Filter, PCF)的方法来实现软阴影效果,如下图所示。我们在采样得到的结果进行插值,不过这里的插值和我们讨论的纹理采样插值有所不同,我们并非对采样得到的深度值的进行插值,而是对得到的阴影因子(shadow factor,不在阴影中为1,在阴影中为0)进行插值,从而使得阴影的边缘能够进行柔和的过渡,不会产生阴影到非阴影的突变。4-tap PCF的过滤方式如下图所示,我们以四个采样结果来计算对应的阴影颜色,得到的阴影因子为0.25,得到的是过渡的阴影颜色。
软阴影
理想化的点光源(体积无限小)会形成硬阴影。因为光源没有体积,光线要么被物体完全挡住(形成全阴影,Umbra),要么完全没被挡住(形成全光照),不存在中间状态。
软阴影的本质就是模拟光源的体积,计算片元对光源的可见覆盖率。覆盖率从0%(本影)到100%(完全照亮)的连续变化,就形成了半影的过渡区域。
PCF(百分比渐近过滤)
传统的硬阴影在比较深度时,只对阴影贴图进行一次采样(D2),结果是非0即1(阴影或非阴影)。PCF不再只采样一次,而是在当前采样点周围取一个区域(例如3x3的 kernel),进行多次深度比较,得到多个(如9个)非0即1的结果。然后对这多个结果取平均值。例如,9次采样中有5次显示在阴影中,4次显示被照亮,那么该片段的阴影亮度就是 5/9 ≈ 0.55。这个平均值不再是二元的0或1,而是一个介于0到1之间的灰度值,从而在视觉上产生了边缘模糊的效果。
PCSS(百分比渐近软阴影)
很多引擎的标配
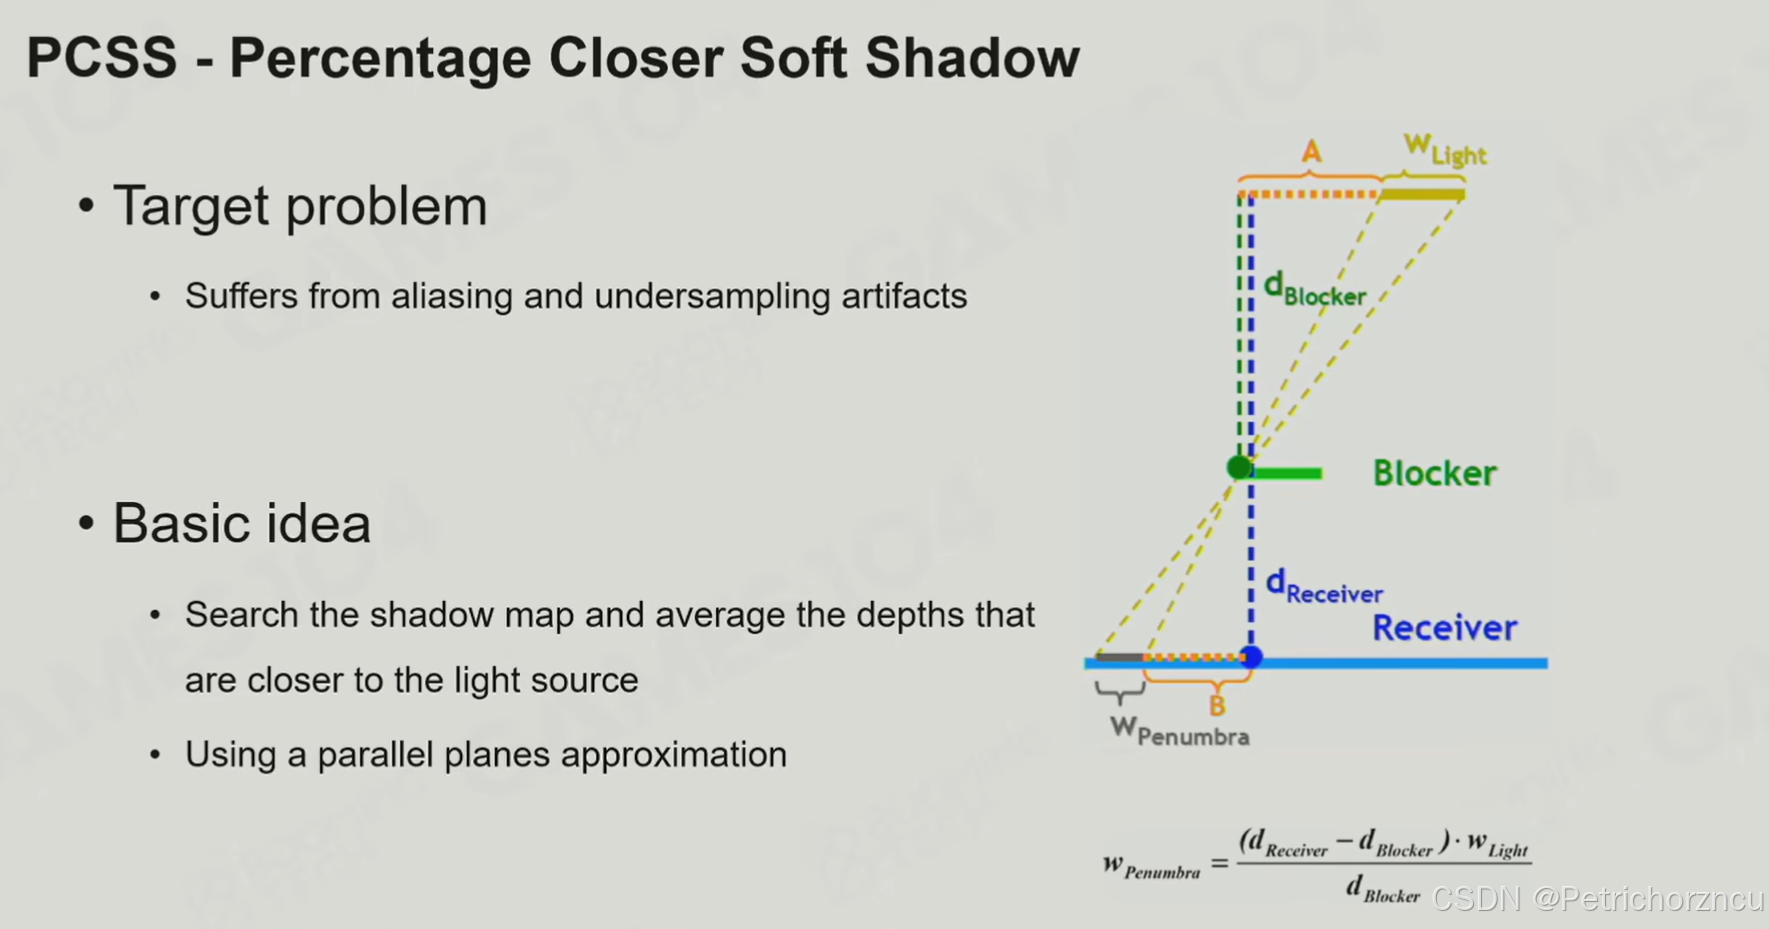
- Blocker Search: 在当前片段位置,不仅采样深度,还要在一个区域内搜索有多少深度值比当前片段小(这些是"遮挡物")。计算这些遮挡物的平均深度。
- Penumbra Size Estimation: 根据光源大小、遮挡物平均深度和当前片段深度,计算出半影的宽度。(公式原理:相似三角形)
- PCF Filtering: 使用上一步计算出的动态半影宽度来决定PCF滤波的Kernel大小。半影宽,就用大的Kernel去采样;半影窄,就用小的Kernel。
Draw Call
在计算机图形编程中,drawcall(绘制调用)是指向图形处理单元(GPU)发出的命令,用于渲染或绘制一个或多个图形对象。每个drawcal命令都包含了绘制一个或多个三维图形对象所需的所有信息,例如对象的顶点数据、纹理贴图、着色器程序等。
drawcall数量一般与以下几个因素有关:
- 对象数量:每个对象都需要至少一个drawcal来进行渲染。如果场景中有大量的独立对象,那么drawcal的数量就会增加。
- 材质数量:每个材质都需要进行一次drawcall。如果场景中的对象使用了不同的材质,那么drawcall的数量会随着材质数量的增加而增加。
- 纹理贴图:每个纹理贴图都需要进行一次drawca。如果对象使用了多个纹理贴图,那么drawcall的数量会增加。
举几个例子来说明drawcall数量的关系:
- 场景中有100个独立的立方体对象,每个对象使用相同的材质和纹理贴图。在这种情况下,绘制调用数量将是100,因为每个对象都需要一个drawcall。
- 场景中有100个独立的立方体对象,每个对象使用不同的材质和纹理贴图。在这种情况下,绘制调用数量将大于100,因为每个对象的材质和纹理贴图不同,需要额外的drawcall。
- 场景中有一个复杂的角色模型,它使用了多个纹理贴图和材质。该模型的渲染可能需要多个drawcall,其中一个用于模型本身的绘制,其他drawcall用于每个纹理贴图的绘制。
需要注意的是,过多的drawcall数量可能会对性能产生负面影响,因为在每个drawcal之间切换上下文会引入额外的开销。优化drawcal数量是提高图形性能的一项重要任务,可以通过合并对象、合并材质和纹理等方式来减少drawcall的数量。
合批
CPU准备和提交一个Draw Call是有开销的。如果场景中有成千上万个物体,每个都产生一个Draw Call,CPU就会不堪重负,成为性能瓶颈(CPU-Bound)。合批的核心思想就是将多个物体的渲染数据合并起来,用一次Draw Call绘制出来,从而极大减轻CPU的负担。
静态合批 (Static Batching)
- 是什么? 将不会移动、旋转、缩放的静态物体(如场景中的建筑、岩石、道路)在运行前(通常是加载时)合并成一个大的顶点/索引缓冲区。
- 工作原理:
- 预处理: Unity编辑器会在构建时,或者场景加载时,将所有标记为
Static且使用相同材质的物体的网格数据合并起来。 - 渲染: 合并后,这些物体在GPU看来就是一个单一的、庞大的网格。因此只需要一次Draw Call就可以全部绘制出来,效率极高。
- 预处理: Unity编辑器会在构建时,或者场景加载时,将所有标记为
- 优点:
- 性能收益巨大: 这是减少Draw Call最有效的手段之一。
- 缺点/代价:
- 内存开销: 合并后的网格会额外占用一份内存。如果多个相同物体原本是共享同一份网格数据的,合批后每个物体都会有自己的顶点数据副本,导致内存占用增加。
- 只适用于静态物体: 物体一旦参与静态合批,就无法再变换(移动、旋转、缩放)。
动态合批 (Dynamic Batching)
- 是什么? Unity运行时每帧自动将小型动态物体的网格数据转换到世界空间,并合并到一个共享的顶点缓冲区中,然后用一个Draw Call绘制。
- 工作原理:
- 每帧运行时: CPU在每帧渲染前,会遍历所有使用同一材质、且满足合批条件的小型动态物体。
- CPU变换: 将它们的顶点数据从本地空间变换到世界空间(这个计算是在CPU上完成的!)。
- 数据合并: 将变换后的顶点数据合并到一个公共的顶点缓冲区中。
- 绘制: 发起一次Draw Call。
- 优点:
- 适用于动态物体: 物体可以自由移动。
- 缺点/严格限制:
- 极大的CPU开销: 顶点变换本应是GPU的强项,动态合批却把这个负担交给了CPU。如果每帧有大量顶点需要CPU来变换,会造成严重的CPU性能问题。
- 极其苛刻的条件(很容易被打断):
- 网格顶点数限制: 通常单个网格的顶点数量不能超过300个(这个数字因Unity版本和平台而异)。
- 同一材质: 必须使用完全相同的材质实例。即使两个材质引用的是同一个Shader和纹理,但只要是不同的材质实例,就无法合批。
- 统一的缩放: 物体的缩放必须是一致的(例如
(2,2,2)),不能是非统一缩放(例如(1,2,1))。
合批被打断的情况
合批的过程非常脆弱,任何导致渲染状态不一致的因素都会中断合批,导致拆分成多个Draw Call。
- 使用不同的材质实例 (Most Common!)
- 这是最常见的原因。即使两个材质球看起来一模一样,只要它们是Project窗口中的两个独立资产,就会被视为不同的材质实例,从而中断合批。
- 解决方案: 对于需要合批的相同物体,务必在代码中共享同一个材质实例。可以通过
MaterialPropertyBlock来修改渲染属性(如颜色)而不中断合批。
- 渲染顺序中断
- 如果两个可合批的物体中间,插入了一个使用不同材质的物体,就会打断合批流程。
- 例如: 渲染序列为
[物体A(材质1), 物体B(材质1), 物体C(材质2), 物体D(材质1)]。 - 理想情况下,A、B、D可以合批。但因为C的插入,合批序列被打断,最终会变成:
[A+B]->[C]->[D],共3个 Draw Call。D无法和前面的A+B合在一起。
- 不满足动态合批的苛刻条件
- 物体顶点数超标、使用了非统一缩放、包含了多个Pass的Shader等,都会导致该物体无法参与动态合批。
- GPU Instancing
- 这是一个更高级的合批技术,但它和动态合批是互斥的。如果材质开启了GPU Instancing,物体就不会再尝试动态合批。
常见的渲染优化技术
合并、要么减面、要么剔除
- LOD: LOD技术通过在远离相机的对象上使用较低细节的模型或纹理,从而减少渲染工作量。这样可以在保持远处物体的视觉一致性的同时,减少多边形数量和纹理负载,提高率。
- 视锥剔除(Frustum Culling): 视锥剔除通过检查物体是否在相机的视锥体内来决定是否渲染它们。这样可以避免不可见物体的渲染,减少不必要的计算和绘制操作,提高染性能。
- Batching合批: 合批技术将具有相同材质或相似渲染状态的物体合并为一个渲染批次。这样可以减少渲染调用的数量,减少状态切换的开销,提高渲染效率。
- 动态物体排序: 对于大量移动或可变形的物体,根据它们在场景中的位置或其他属性,动态地对物体进行排序。这可以最大限度地利用渲染管线的性能,避免不必要的绘制操作和状态切换,提高渲染性能。
- GPU Instancing: GPU实例化允许将相同的模型实例化多次,在一次渲染调用中同时绘制多个实例。这样可以减少渲染调用的数量,降低CPU和GPU之间的通信开销,提高渲染效率。
- 屏幕空间技术: 屏幕空间技术(如SSAO、SSR)在屏幕空间中进行采样和计算,减少对整个场景的计算需求。
- Shader指令数优化: 通过对着色器进行优化,如减少不必要的计算和采样操作、使用更高效的算法和数据结构,可以降低渲染的开销,提高渲染性能。