
一边是 Claude Code 的实现细节(工具、上下文压缩、安全检查),一边是大模型岗位的面试题。前者告诉你它怎么工作,后者告诉你别人怎么考。
1. ClaudeCode源码学习经验
Anthropic的工程师在发布时忘记排除source map文件。Source map是编译后的代码到源码的映射文件,有了它就能完整还原TypeScript源码。
学习的内容包括:
- 完整的系统提示词——约8,700 token,包含所有行为规则
- 18+内置工具的完整定义——每个工具的参数、描述、使用规则
- 安全检查机制——23层顺序检查的完整逻辑
- 子Agent架构——Explore、Plan、General-purpose三种子Agent的设计
- 上下文管理策略——200K窗口的三层压缩机制
- 权限系统——deny > ask > allow的评估顺序
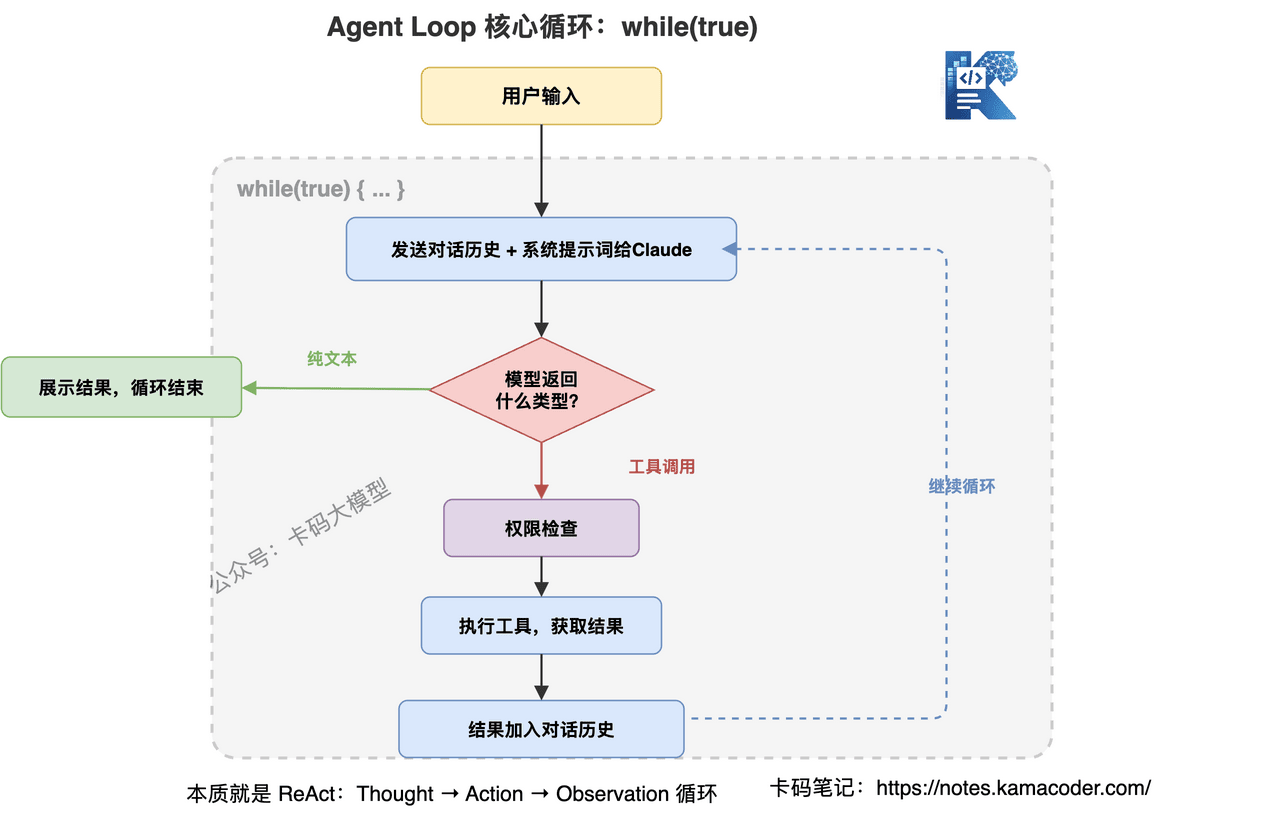
AI编程工具是多轮自主决策:你说"帮我修这个bug",AI可能需要:
- 先读文件,理解代码结构
- 再搜索相关文件,找到问题根源
- 编辑代码,修复bug
- 运行测试,验证修复
- 发现测试还有问题,继续修
- 最终确认修复完成,返回结果
每一步都是循环里的一次迭代。模型自己决定下一步做什么,直到它认为任务完成。
停止条件
循环什么时候停?两种情况:
- 模型返回纯文本——模型认为任务完成了,不再调用工具,直接输出结果
- 触发安全限制——比如工具调用次数超限、用户手动中断
这个设计的精妙之处在于:停止条件是模型自己判断的。不是写死的"调用3次工具就停",而是模型根据任务完成度自主决定。这就是为什么Claude Code有时候能连续执行几十步操作来完成一个复杂任务。
系统提示词的构成
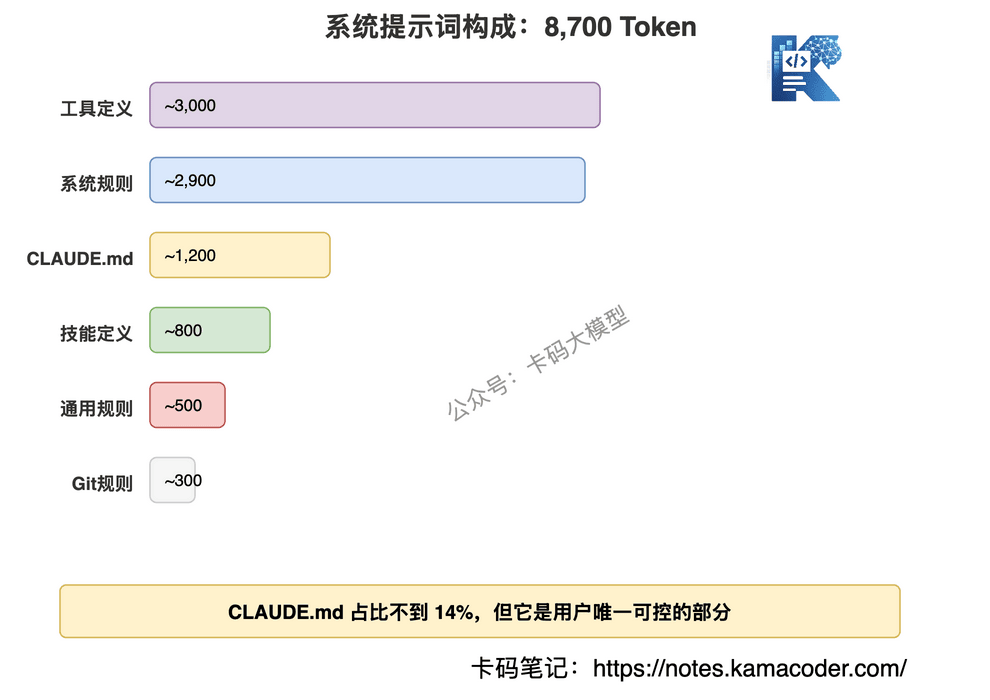
系统提示词不是一整块文本,而是由多个模块拼接而成:
| 模块 | Token数 | 作用 |
|---|---|---|
| 系统规则 | ~2,900 | 核心行为准则、安全规则 |
| 工具定义 | ~3,000 | 18+工具的参数和使用说明 |
| CLAUDE.md | ~1,200 | 项目级自定义指令 |
| 通用规则 | ~500 | 代码风格、输出格式 |
| Git规则 | ~300 | Git操作的安全规范 |
| 技能定义 | ~800 | 可调用的技能列表 |
这里有一个非常有意思的设计决策:CLAUDE.md的内容不是放在系统提示词里,而是作为用户消息注入的。
系统提示词的优先级最高,如果CLAUDE.md放在系统提示词里,用户的自定义指令就会和Anthropic的安全规则同级,可能被用来绕过安全限制。把CLAUDE.md作为用户消息注入,优先级低于系统提示词中的安全规则,但高于普通用户消息。这是一个安全和灵活性的平衡。
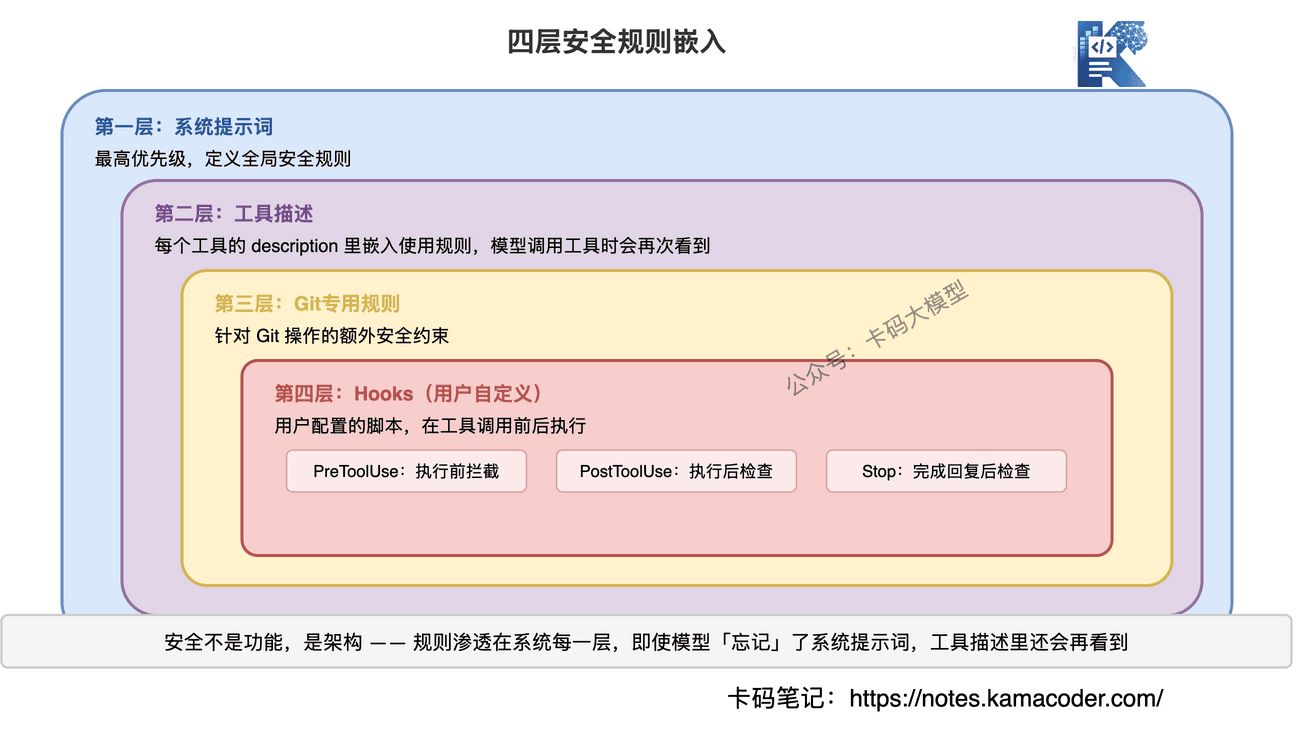
Claude Code的系统提示词有一个特别的设计:安全规则不只写在系统提示词里,还嵌入在每个工具的描述中。双重保险保证了调用工具
比如Bash工具的描述里就写了:
- 不要用cat/head/tail读文件,用Read工具
- 不要用sed/awk编辑文件,用Edit工具
- 不要用echo写文件,用Write工具
内置工具设置
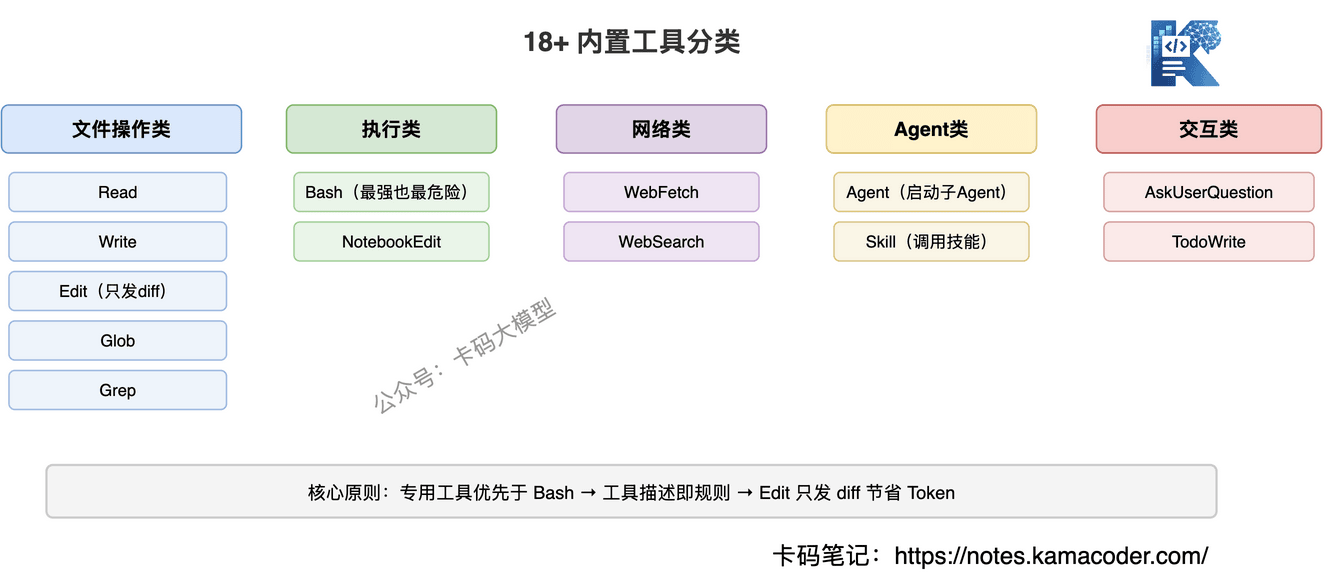
按功能分类:
文件操作类
| 工具 | 功能 | 关键特点 |
|---|---|---|
| Read | 读取文件 | 支持图片、PDF、Jupyter Notebook |
| Write | 写入文件 | 完整覆盖,适合新建文件 |
| Edit | 编辑文件 | 精确替换,只发送diff |
| Glob | 文件搜索 | 按模式匹配文件路径 |
| Grep | 内容搜索 | 在文件内容中搜索关键词 |
执行类
| 工具 | 功能 | 关键特点 |
|---|---|---|
| Bash | 执行Shell命令 | 支持超时、后台运行 |
| NotebookEdit | 编辑Jupyter | 操作notebook的cell |
网络类
| 工具 | 功能 | 关键特点 |
|---|---|---|
| WebFetch | 抓取网页 | 自动HTML转Markdown |
| WebSearch | 搜索网络 | 获取实时信息 |
Agent类
| 工具 | 功能 | 关键特点 |
|---|---|---|
| Agent | 启动子Agent | 并行处理复杂任务 |
| Skill | 调用技能 | 执行预定义的工作流 |
交互类
| 工具 | 功能 | 关键特点 |
|---|---|---|
| AskUserQuestion | 向用户提问 | 多选/单选/自由输入 |
| TodoWrite | 任务管理 | 创建和跟踪任务列表 |
工具设计的核心原则
原则一:专用工具优先于通用命令
Claude Code的系统提示词里明确写了:
“Prefer dedicated tools over Bash when one fits (Read, Edit, Write) — reserve Bash for shell-only operations.”
不直接用Bash的原因,专用工具有更好的错误处理、权限控制和用户体验。用户能看到"Claude正在编辑文件",而不是看到一堆shell命令。
原则二:Edit工具只发送diff
这是一个很聪明的设计。Edit工具不是重写整个文件,而是指定old_string和new_string,只替换匹配的部分。
好处:
- 节省Token——不需要在上下文里放整个文件内容
- 减少冲突——只改需要改的部分
- 便于审查——用户一眼看到改了什么
坏处:
old_string必须唯一匹配——如果文件里有重复内容,需要提供更多上下文来定位
原则三:工具描述即规则
每个工具的description字段里都嵌入了使用规则。比如Bash工具的描述长达几百字,包含:
- 什么时候该用Bash,什么时候不该用
- 怎么处理长时间运行的命令
- Git操作的安全规范
- 多命令并行的最佳实践
模型每次想调用工具时,都会重新看到这些规则。 这比只在系统提示词里写一次要可靠得多。强化了记忆,避免了中间迷失
Bash工具:最强大也最危险
Bash是Claude Code里最强大的工具——理论上它能执行任何shell命令。但也正因如此,它的限制最多:
- 默认2分钟超时——防止无限循环
- 不支持交互式命令——不能用vim、不能用git rebase -i
- 长时间命令要后台运行——dev server、watch模式不能阻塞
- 权限检查最严格——rm -rf、git push –force都需要用户确认
这个设计体现了一个核心理念:给AI足够的能力,但用规则约束它的行为边界。
五、子Agent工作机制
上下文是怎么被吃掉的
一个典型的编程任务,上下文消耗大概是这样的:
| 内容 | Token消耗 |
|---|---|
| 系统提示词 | ~8,700 |
| 用户的问题 | ~100-500 |
| 读一个文件(500行) | ~3,000-5,000 |
| Bash命令输出 | ~500-2,000 |
| 模型的思考和回复 | ~1,000-3,000 |
| 每轮工具调用结果 | ~1,000-5,000 |
一个"帮我修这个bug"的任务,可能需要读5-10个文件、执行几次搜索、多次编辑——轻松消耗50K-100K token。复杂任务甚至能把200K吃满。
三层压缩机制
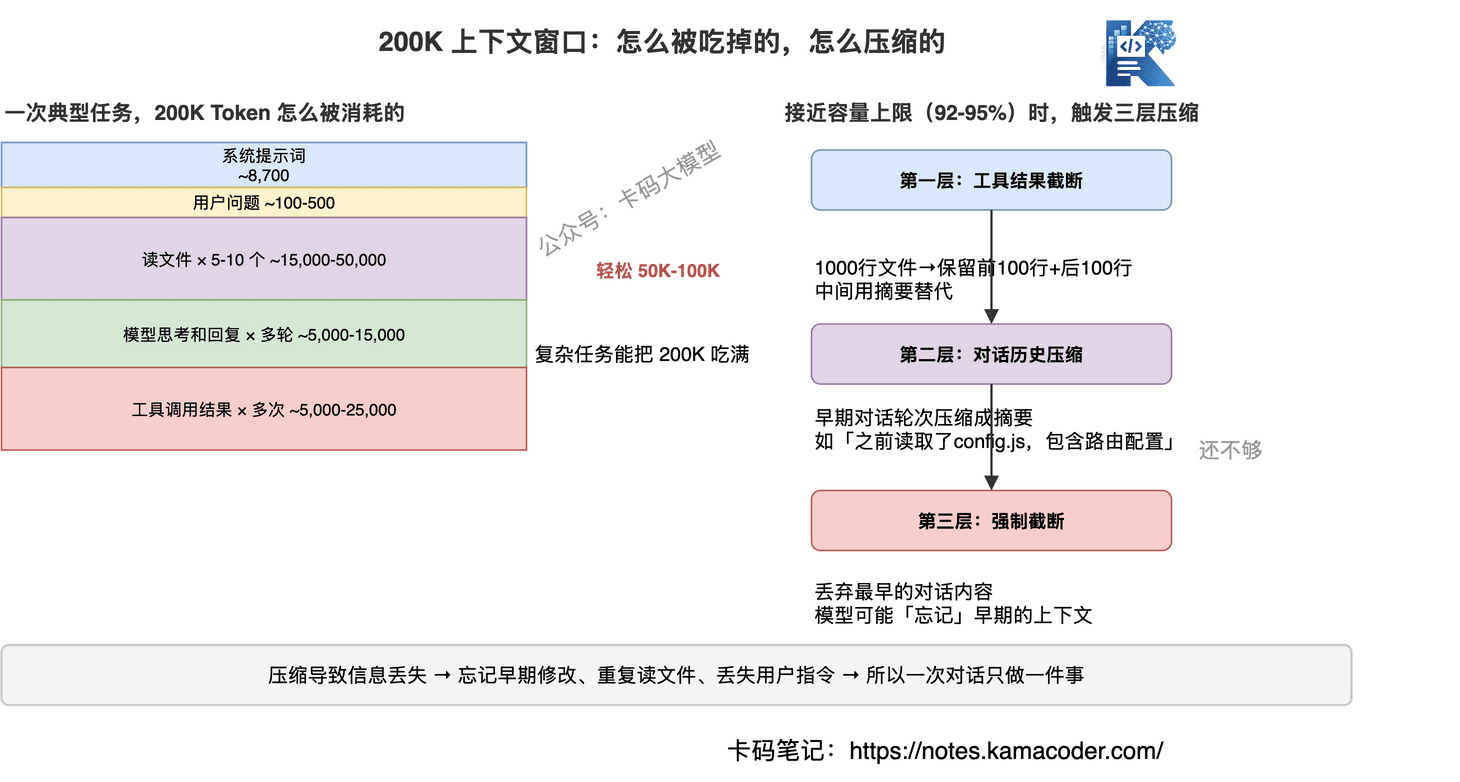
当上下文接近容量上限(92-95%)时,Claude Code会触发压缩机制。这个机制分三层:
第一层:工具结果截断
最先被压缩的是工具调用的结果。比如你读了一个1000行的文件,压缩后可能只保留前100行和后100行,中间用摘要替代。
第二层:对话历史压缩
早期的对话轮次会被压缩成摘要。比如你30分钟前让AI读的文件内容,会被压缩成"之前读取了config.js文件,其中包含路由配置"这样的摘要。
第三层:强制截断
如果前两层压缩还不够,会强制截断最早的对话内容。这时候模型可能会"忘记"早期的上下文。
压缩带来的问题
压缩会导致信息丢失。最常见的问题:
- 忘记早期的修改——你让AI改了文件A,后来又改了很多文件,回头发现AI忘了文件A的修改内容
- 重复读取文件——AI忘了之前读过某个文件,又读一遍,浪费token
- 丢失用户指令——你在对话开头说的"不要改这个文件",可能在压缩后被丢掉
实际使用建议
理解了上下文管理机制,你就知道怎么更高效地使用Claude Code:
- 一次对话只做一件事——不要在一个对话里又修bug又加功能又重构,上下文会爆
- 关键指令放在最近的消息里——不要指望AI记住你30分钟前说的话
- 复杂任务用CLAUDE.md——把项目规则写在CLAUDE.md里,每次对话都会加载,不会被压缩掉
- 善用子Agent——让Explore Agent去读文件,主Agent的上下文就不会被大量代码占满
七、23层安全检查
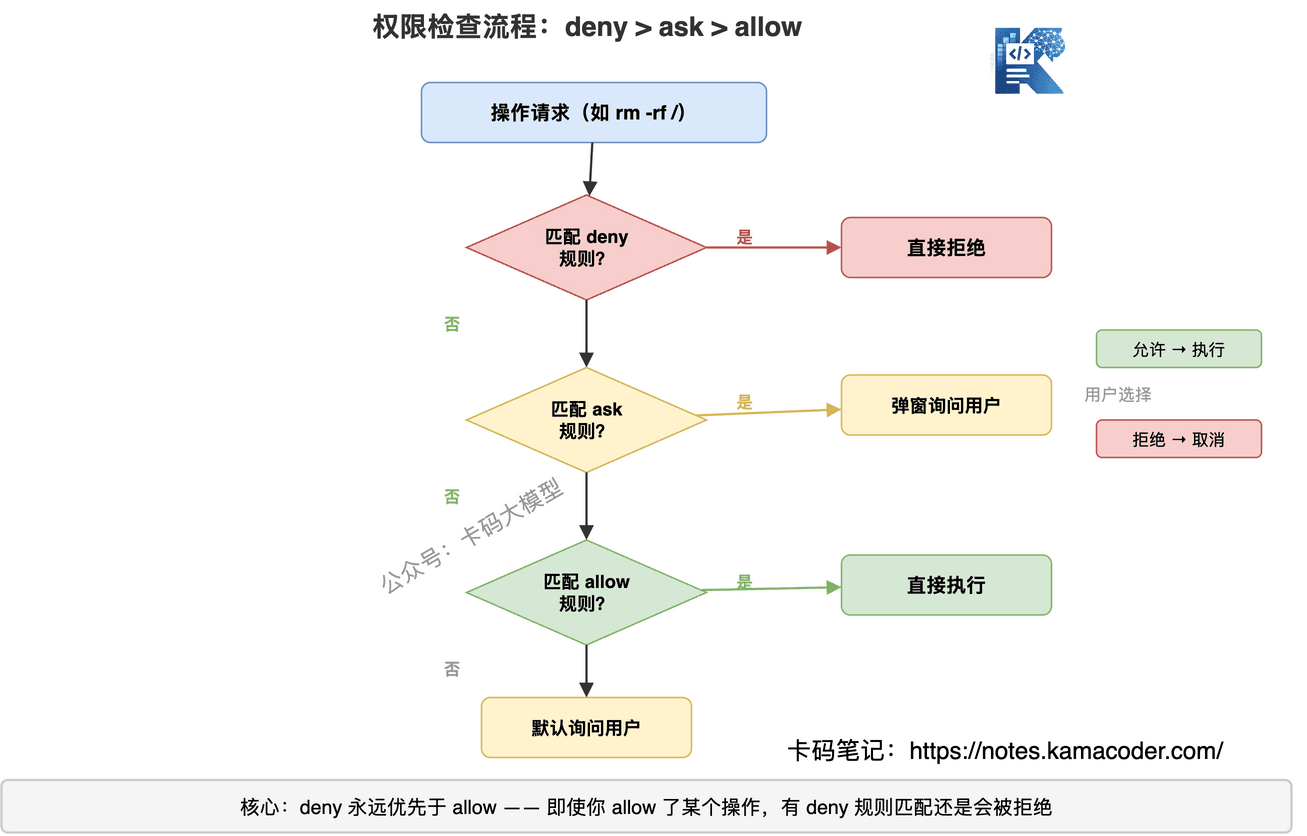 Claude Code的权限评估遵循严格的优先级:
- deny(拒绝)——最高优先级,匹配到就直接拒绝,不问用户
- ask(询问)——中间优先级,匹配到就弹窗问用户是否允许
- allow(允许)——最低优先级,匹配到就直接执行
这个顺序很重要:deny永远优先于allow。 即使你在配置里allow了某个操作,如果有deny规则匹配,还是会被拒绝。
Claude Code的安全规则不是集中在一个地方,而是分散嵌入在系统的各个层面:
双模型安全检查
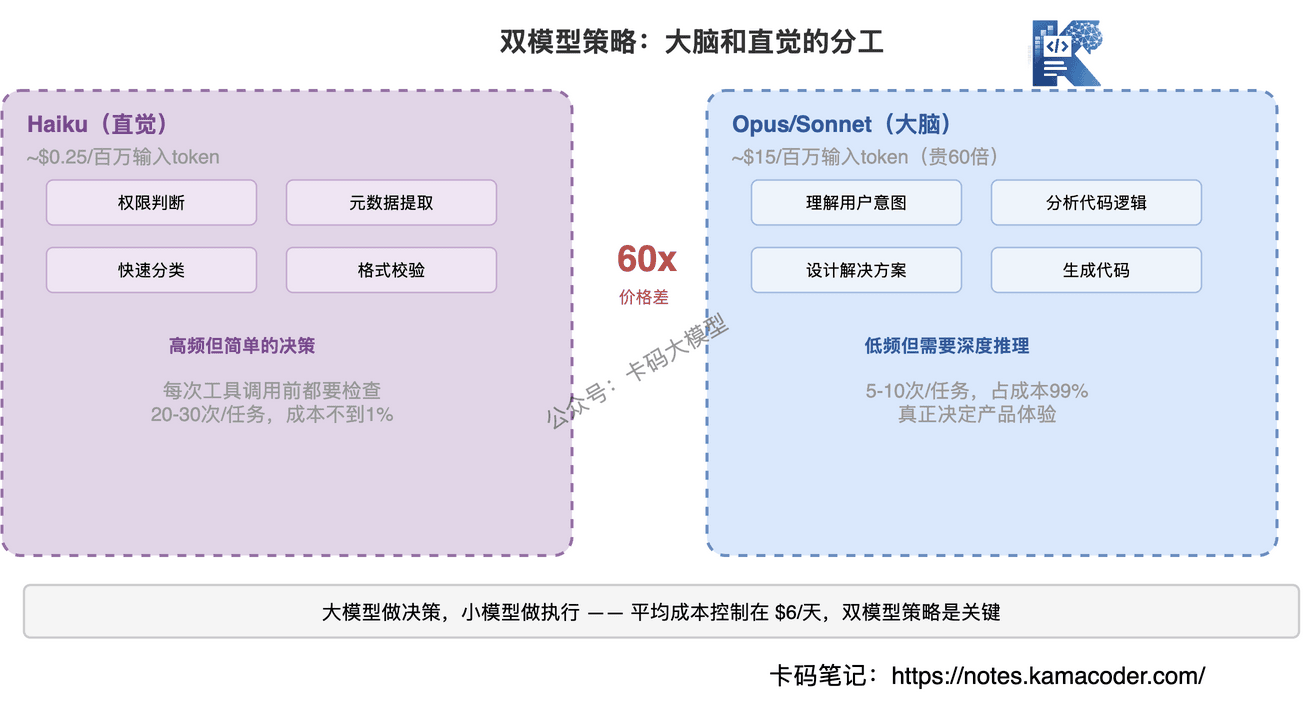
这里有一个很巧妙的设计:Claude Code用两个模型做安全检查。
- Haiku(小模型):做快速的权限判断——这个操作需不需要问用户?
- Opus/Sonnet(大模型):做复杂的安全推理——这个操作有没有潜在风险?
不全用大模型是因为,权限检查是高频操作,每次工具调用都要检查。用Haiku做初筛,成本低、速度快;只有需要复杂判断时才用大模型。
八、CLAUDE.md和记忆系统
面试官会问:“CLAUDE.md是干什么的?为什么不能放在系统提示词里?“或者"AI的记忆系统怎么设计?记忆和实际代码状态不一致怎么办?”
每次开启新对话,Claude Code都是一张白纸,CLAUDE.md就是解决项目结构、编码规范、技术栈偏好的问题。
CLAUDE.md:项目级的"说明书”
CLAUDE.md是一个放在项目根目录的文件,每次对话开始时会自动加载到上下文中。你可以在里面写:
- 项目架构说明
- 常用命令(构建、测试、部署)
- 编码规范和风格要求
- 技术栈和依赖说明
- 已知问题和注意事项
| |
三层CLAUDE.md
Claude Code支持三个层级的CLAUDE.md,优先级从高到低:
| 层级 | 位置 | 作用域 |
|---|---|---|
| 项目级 | 项目根目录/CLAUDE.md | 整个项目 |
| 目录级 | 子目录/CLAUDE.md | 该目录下的文件 |
| 用户级 | ~/.claude/CLAUDE.md | 所有项目 |
目录级CLAUDE.md特别有用。 比如你的前端目录和后端目录有不同的编码规范,可以分别写CLAUDE.md。
记忆系统:跨对话的持久化
CLAUDE.md解决了项目级的上下文问题,但还有一类信息是跨项目、跨对话的——比如你的编码偏好、你的角色背景、你之前给过的反馈。
Claude Code的记忆系统用文件存储这些信息:
| |
记忆分四种类型:
- user:用户的角色、偏好、知识背景
- feedback:用户对AI行为的纠正和确认
- project:项目的目标、进度、决策背景
- reference:外部资源的指针(如"bug追踪在Linear的INGEST项目里")
记忆的核心原则:“可疑索引,不是可信真相”
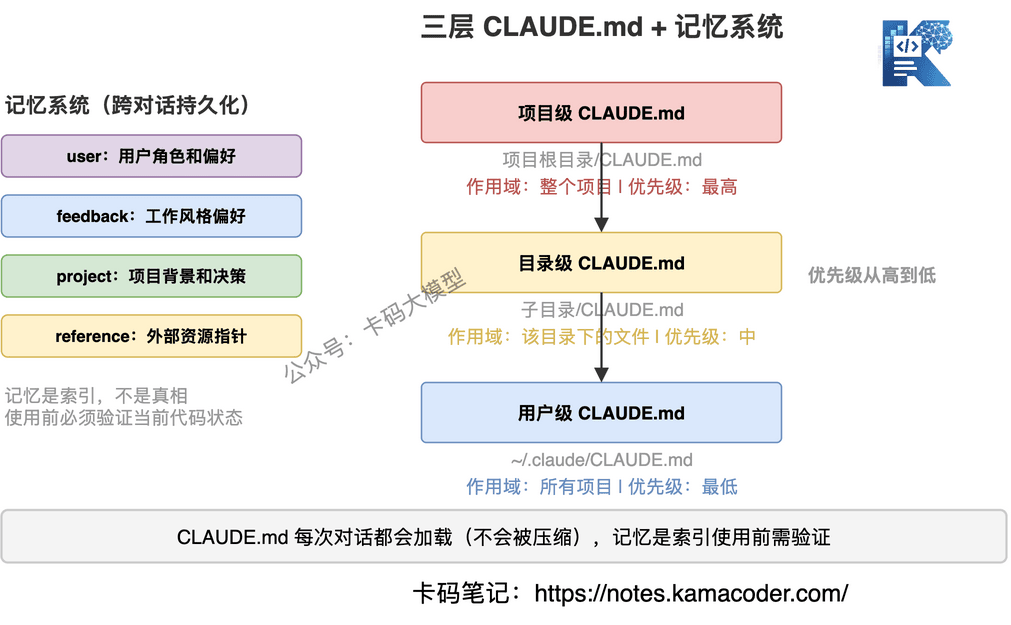
这是记忆系统设计中最重要的一点:记忆是索引,不是真相。
系统提示词里明确写了:
“Memory records can become stale over time… Before answering the user or building assumptions based solely on information in memory records, verify that the memory is still correct and up-to-date by reading the current state of the files.”
翻译成人话:AI不能因为记忆里写了"config.js在第50行有路由配置"就直接去改第50行——它必须先读文件确认。 因为上次记忆的时候是第50行,现在可能已经变了。
这个设计非常务实。记忆帮AI快速定位信息,但最终决策必须基于当前代码的实际状态。
CLAUDE.md的安全边界
前面提到,CLAUDE.md是作为用户消息注入的,不是系统提示词。这意味着:
- CLAUDE.md不能覆盖Anthropic的安全规则
- CLAUDE.md不能让AI执行被deny的操作
- CLAUDE.md可以自定义编码风格、项目规范、工作流程
这是一个精心设计的信任边界:项目维护者可以定制AI的行为,但不能突破安全底线。
九、双模型策略怎么分工?成本怎么控制?
面试官会问:“Claude Code为什么用两个模型?全用大模型不行吗?“或者"双模型策略的成本优化效果怎么样?什么操作用小模型,什么操作用大模型?”
Claude Code不是只用一个模型,而是用两个模型配合工作。这是一个非常聪明的成本优化策略。
两个模型,两种角色
十、从Claude Code能学到什么对开发者有用的?
启示一:Agent架构没有魔法,就是while循环
Agent,核心就是一个while循环+工具调用。没有复杂的状态机,没有花哨的架构模式。
如果你在做Agent开发,不要过度设计。先把最简单的循环跑起来,再逐步加规则、加工具、加安全检查。简单的架构+丰富的规则,比复杂的架构+稀疏的规则更可靠。
而所谓"逐步加规则”,加的就是循环这个控制结构上的工程治理——上下文、状态、预算、工具、终止判断,这套东西现在有个专门的名字叫 Loop Engineering,系统讲解见 从 ReAct 到 Loop Engineering:Agent 到底在循环什么。
启示二:提示词工程是真正的产品壁垒
Claude Code的512,000行代码里,真正决定产品体验的不是代码逻辑,而是那8,700 token的系统提示词。
- 什么时候该问用户,什么时候自己决定
- 什么样的代码风格是好的
- 什么操作是危险的
- 怎么平衡自主性和安全性
这些"软规则"才是AI产品的核心竞争力。 代码可以抄,提示词的调优经验抄不走。
启示三:安全不是功能,是架构
Claude Code的安全机制不是一个独立的模块,而是渗透在系统的每一层:系统提示词、工具描述、权限模型、Hooks、双模型检查。
如果你在开发AI应用,安全必须从架构层面考虑,不能事后补。
启示四:上下文管理决定了AI的"智商上限"
很多人抱怨AI"变笨了"“忘记了之前说的话”。现在你知道原因了——上下文窗口被压缩了,信息丢失了。
理解这个机制后,你可以:
- 把重要信息写在CLAUDE.md里(不会被压缩)
- 一次对话只做一件事(减少上下文消耗)
- 关键指令放在最近的消息里(最后被压缩)
不是AI笨,是你没有在它的认知范围内给够信息。
启示五:双模型策略是AI应用的标配
不是所有任务都需要最强的模型。Claude Code用Haiku做权限检查、用Opus做代码推理,成本降了几十倍。
如果你在开发AI应用,想想哪些环节可以用小模型:
- 意图分类 → 小模型
- 内容过滤 → 小模型
- 格式校验 → 小模型
- 核心推理 → 大模型
大模型做决策,小模型做执行——这是成本和效果的最优解
十一、大厂真实面试追问汇总
以下是各大厂在AI编程工具方向的真实追问,整理汇总。
系统设计类
Q:如果让你设计一个AI编程工具,你会怎么设计安全机制?
必答四个要点:
- 分层嵌入——安全规则不能只放在系统提示词里,要嵌进工具描述、专用规则、用户Hooks,做到即使模型"忘记"某一层,还有其他层兜底
- 权限分级——deny > ask > allow 严格优先级,deny永远覆盖allow,不能被用户配置绕过
- 不可逆操作必须确认——rm -rf、git push –force、数据库DROP等操作,永远不能自动执行
- 审计可追溯——所有工具调用记录完整日志,出问题能回溯定位
Q:AI编程工具的上下文窗口管理有什么挑战?怎么解决?
核心矛盾:任务越复杂,需要的信息越多,但窗口只有200K。
解决策略:
- 专用工具节省Token——Edit只发diff,Glob/Grep按需搜索,不全量加载文件
- 分层压缩——早期对话摘要压缩,中间结果只保留关键信息,系统提示词按模块裁剪
- 子Agent隔离——探索代码库交给Explore Agent,内部消耗100K+,返回父Agent只占1,500-2,000 token
- 双模型路由——简单任务用小模型,减少单次调用Token消耗
原理深挖类
Q:为什么CLAUDE.md不放在系统提示词里?
安全和优先级的平衡。系统提示词优先级最高,如果把CLAUDE.md放进去,用户的自定义指令就和Anthropic的安全规则同级,可能被用来覆盖安全规则。作为用户消息注入,CLAUDE.md的优先级低于系统提示词中的安全规则,但高于普通用户消息。用户能自定义行为,但不能突破安全底线。
Q:子Agent的上下文和父Agent的上下文是什么关系?
完全隔离。子Agent有自己的上下文窗口,不共享父Agent的对话历史。父Agent只给子Agent一个任务描述,子Agent返回一个摘要。这种设计的核心目的是保护父Agent的上下文不被大量代码撑爆。代价是子Agent看不到父Agent的完整上下文,可能重复做父Agent已经做过的工作。
Q:Edit工具为什么只发diff而不是整个文件?
三个好处:节省Token(不需要把整个文件内容放进上下文)、减少冲突(只改需要改的部分)、便于审查(用户一眼看到改了什么)。代价是old_string必须唯一匹配,文件里有重复内容时需要提供更多上下文来定位。这是带宽和精度的权衡——在200K窗口的约束下,省Token是第一优先级。
Q:Claude Code的权限检查为什么用deny > ask > allow而不是allow优先?
因为安全的原则是默认拒绝,显式允许。如果allow优先,用户配置一条allow规则就可能绕过安全检查。deny优先意味着:即使你不小心allow了一个危险操作,只要有deny规则匹配,还是会被拦截。这和防火墙的设计思路一致——宁可多拦截一次,也不要放行一个危险操作。
工程实践类
Q:Claude Code和Cursor、Windsurf有什么区别?
核心架构大同小异,都是Agent Loop + 工具调用 + 上下文管理。区别在于:
- Cursor:IDE深度集成,代码补全是独立功能(不经过Agent Loop),Agent模式类似Claude Code
- Windsurf:Cascade模式自动多步执行,强调"意图理解"
- Claude Code:纯CLI,权限控制最严格,子Agent机制最完善
面试时不要只说"都差不多",要能说出各自的设计取舍。
Q:怎么写好CLAUDE.md?
三条原则:
- 写约束不写愿望——“不要加注释"比"写简洁的代码"更有用,模型对禁止性规则的遵守远强于建议性规则
- 写具体不写抽象——“函数名用驼峰"比"遵循项目风格"更有用,模型需要明确的判断标准
- 写原因不写指令——“VuePress 1.x插件版本必须统一为1.5.3,混用会导致运行时错误"比"注意插件版本"更有用,知道原因模型才能举一反三
Q:实际使用AI编程工具遇到过什么问题?
常见五个坑:
- 上下文污染——对话太长后AI开始"忘记"早期约定 → 解法:新任务开新对话,关键指令放最近的消息
- 幻觉编辑——AI编辑了一个不存在的文件路径 → 解法:用Glob确认路径再编辑
- 过度重构——AI把简单任务改成复杂设计 → 解法:CLAUDE.md里明确写"不要引入不必要的抽象”
- 权限绕过——用户习惯性点"允许全部” → 解法:用plan模式先让AI分析,确认方案再切回default模式
- 成本爆炸——复杂任务消耗大量Token → 解法:拆分子任务,用Explore Agent做前期调研减少主Agent消耗
常见问题(FAQ)
Q:Claude Code 的底层架构是什么?和普通对话有什么区别?
Claude Code 是 while 循环的 Agent 模式,模型决定调用工具、执行后把结果喂回模型、继续循环直到任务完成。普通对话是一问一答,Claude Code 能多轮自主调用工具完成复杂编程任务。
Q:为什么 Claude Code 用专用工具而不是直接用 Bash?
专用工具如 Read、Edit、Glob、Grep 有明确的输入输出 schema,模型更容易正确调用,也方便做权限控制和安全校验;全靠 Bash 则难以约束行为、容易出错和越权。
Q:Claude Code 怎么管理 200K 上下文窗口?
通过 Auto-Compact 自动压缩历史对话、保留任务关键状态、用子 Agent 隔离上下文等机制,避免长任务把上下文窗口撑爆。
Q:Claude Code 的子 Agent 机制怎么工作?
主 Agent 通过 Agent 工具启动 Explore、Plan 等子 Agent,各自独立执行后把结果回传汇总。适合前期调研、大范围搜索这类消耗大量上下文的子任务,避免污染主 Agent。
Q:CLAUDE.md 怎么写才有效?
三条原则是写约束不写愿望、写具体不写抽象、写原因不写指令。禁止性规则比建议性规则更被遵守,明确的判断标准和原因能让模型举一反三。
Q:学 Claude Code 原理对用其他 AI 编程工具有用吗?
有用。Cursor、Windsurf、Copilot 等工具底层架构大同小异,都是 Agent Loop 加工具链加上下文管理加系统提示词,理解 Claude Code 就能理解这一类 AI 编程工具。
2. 大模型面经
主要包括Agent、RAG、Function Calling、微调
大模型面试考的是:
- 你能不能设计一个Agent系统? 不是调个API就行,面试官会追问记忆、工具调用、幻觉控制
- 你能不能讲清楚RAG的难点? 不是"检索+生成"四个字就完了,文档预处理、召回质量、生成忠实度,三座大山
- 你能不能说清Transformer的核心? 不用推公式,但Self-Attention、位置编码、三大架构选择得说得明白
Agent面试题
Agent是大模型面试的第一高频方向,会直接而给的是情景题,设计一个具体的Agent
RAG检索增强面试题
RAG是大模型落地的第一站,也是满是管考察工程能力的试金石
面试官最常问的:RAG落地最难的地方在哪里
Transformer原理面试题
不是单纯的公式推理,而是考:为什么所有的大模型都绕不开Transformer?三大架构增么选,O(n^2)复杂度怎样优化?
模型微调面试题
微调是大模型面试的分水岭——会答的说明你真做过,不会答的说明只停留在调API层面。
基模越来越强的今天,面试官最爱问:“RLHF还有必要吗?SFT还值得做吗?”
就业目标应当是:LLM应用工程师
几个雷点;
- 本质工作还hi传统岗位,大模型不是你的主页,是你的差异化竞争力
- 大模型开发与传统开发相比是并列关系,业务框架依然要 SpringBoot,高性能 RPC 依然要 C++,高并发服务依然要用 Go
- 和算法岗相比,算法岗该模型(训练、微调、对齐)应用岗位(RAG、Agent、部署),都需要略懂微调、懂Transformer,应用岗是为了做选型判断
- 大模型开发以python为主
- 对于传统行业而言是在传统的业务上新增了业务的要求
Vibe Coding
VibeCoding的定义:
不审查,不理解,直接Accept AI生成的代码。
| 维度 | Vibe Coding | AI 辅助编程 |
|---|---|---|
| 代码生成 | AI 生成 | AI 生成 |
| 代码审查 | 不看,直接 Accept | 逐行审查 |
| 报错处理 | 粘贴给 AI | 分析根因再决定 |
| 对代码负责 | 不负责 | 完全负责 |
AI越来越强的时代,优势是什么
优势一:定义问题的能力
对于模糊的需求进行定义,把一句话变成可执行的规格,AI才能写出正确的代码,将模糊需求拆解成为清晰的技术规格——边界条件,异常处理、业务规则,这些AI不会主动问你,但是不说清楚代码一定写的不对。
优势二:上下文构建能力
AI的输出质量,直接取决于给的上下文的质量。描述尽可能地详细,包括业务规则、数据库表结构、上下游接口文档,尽量都是强相关的代码
结合AI生成游戏逻辑时的场景,时间短并不能说明问题,重要的是创意的落地,提示词的水品,对于功能的描述
优势三:结果验证能力
代码跑起来了不等于代码对了,因为测试时按照个人的主观预期写的并不一定符合业务需求,需要更精细化的并非流程上的跑通,而是参数上的对比
优势四:技术决策能力
AI能够提供相应的建议,但是通用乘警之间和具体场景之间,永远需要人来做判断。决策要考虑的不仅是技术因素,还有团队现状、业务阶段、历史教训
优势五:成本控制能力
成本控制能力包括:
- 知道什么时候用大模型,什么时候用小模型
- 知道怎么组织上下文才能省 Token
- 知道怎么写 Prompt 才能减少来回次数
- 知道哪些任务让 AI 做更贵,自己做更便宜
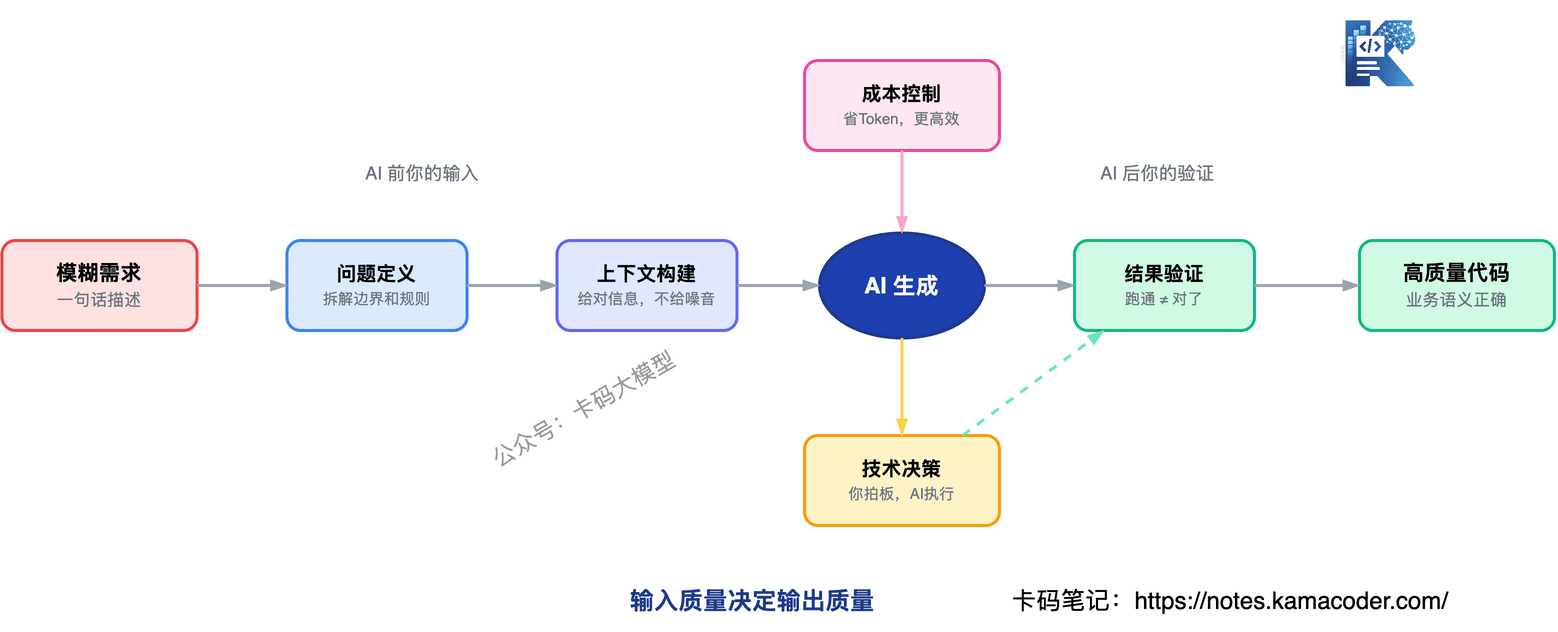
关于AI编程工具的Token成本控制
策略一:模型路由——活用模型
不同的工作用不同的模型,简单补全用小模型,复杂任务才用大模型。70% 的日常编码任务其实不需要最强模型,这样整体 Token 成本能降 60% 以上。
策略二:上下文管理——别把整个代码库都塞进去
正确的做法:
- 只给相关的代码:修改用户模块,就不要把支付模块的代码也塞进去
- 用摘要代替全文:不需要把 500 行的配置文件全给 AI,给关键部分就行
- 按需加载:先让 AI 看接口定义,需要实现细节时再给具体代码
- 定期清理上下文:长时间对话会积累大量历史 Token,该开新会话就开新会话
AI 读到的无关代码越多,生成质量反而越差。因为无关信息会干扰模型的注意力,让它关注到不该关注的地方。所以上下文管理不只是省钱,也是在提升质量。
策略三:Prompt优化——一次性说清楚别来回改
怎么写好 Prompt:
- 说清楚目标:不是"写个接口”,是"写一个 REST 接口,接收退款请求,参数包括订单号和退款金额,需要幂等校验"
- 说清楚约束:性能要求、安全要求、代码规范
- 说清楚上下文:相关的数据库表结构、上下游接口
- 给示例:一个具体的输入输出示例,比 100 字描述更有效
策略四:缓存和复用
相似的问题,不要让 AI 从零生成。
- Prompt 缓存:相同的 Prompt 前缀,API 层面可以缓存,省掉重复计算的 Token。Anthropic 的 API 已经原生支持了 Prompt Caching,相同前缀的输入可以打到 90% 的缓存命中率
- 代码模板:常见的 CRUD 接口、表单验证,维护一套模板,AI 只需要填差异部分
- 会话复用:同一类任务的 Claude Code 会话,可以复用之前的上下文,不要每次从零开始
策略五:评估哪些任务让AI做更贵
适合让 AI 做的:
- 重复性高、模式固定的代码(CRUD、样板代码)
- 你知道要什么但手写太慢的代码
- 需要快速探索多种方案的场景
- 不熟悉的语言或框架的入门代码
不适合让 AI 做的:
- 改一行配置就能解决的小修改
- 你已经非常熟悉的代码区域,手写比解释更快
- 需要深度理解业务上下文的决策型代码
- 已经有精确模板、复制粘贴比生成更快的情况
本文由 2 篇笔记合并整理。